Search: #AI推理

  1. 算力战国策:拆解主流 AI 芯片的技术哲学与架构之争在摩尔定律与登纳德缩放定律放缓后,AI 算力迎来爆发

    算力战国策:拆解主流 AI 芯片的技术哲学与架构之争

    在摩尔定律与登纳德缩放定律放缓后,AI 算力迎来爆发。大模型计算本质上是海量的矩阵乘法(GEMM / GEMV),而决定性能天花板的从来不是单纯的峰值算力,而是数据移动速度——即如何攻破“内存墙”(Memory Wall)

    各大芯片巨头对此给出了截然不同的答卷,形成了当下六大主流 AI 芯片路线:

    ---

    1. NVIDIA GPU:极致通用与生态壁垒

    核心哲学:高度并行的通用处理器。通过 CUDA 保留统一的编程模型,将硬件复杂度包装在 SM 与 Tensor Core 背后。
    架构亮点:通过硬件管理缓存与海量线程(Warp)隐藏访存延迟;从 Blackwell 到 Rubin,引入 TMEM、异步 TMA 与微缩精度(FP4/NVFP4)。
    扩展体系:NVLink + NVSwitch 构建低延迟共享内存域;机架级(如 NVL72 / NVL576)坚持采用无源铜缆背板,以极低功耗实现高达 130 TB/s 的全对全互联。
    护城河:二十年积累的 CUDA 开发者生态与深度优化的算子库(FlashAttention、CUTLASS 等)。

    2. Google TPU:脉动阵列与编译器至上

    核心哲学:专为矩阵乘法而生的专用机器。剔除硬件调度器、分支预测和缓存,把每一拍的调度完全交给 XLA 编译器。
    架构亮点:权重常驻(Weight-Stationary)的 MXU 脉动阵列,搭配纯软件管理的暂存内存(VMEM/CMEM);引入 SparseCore 处理非规则的 Embedding 与推荐负载。
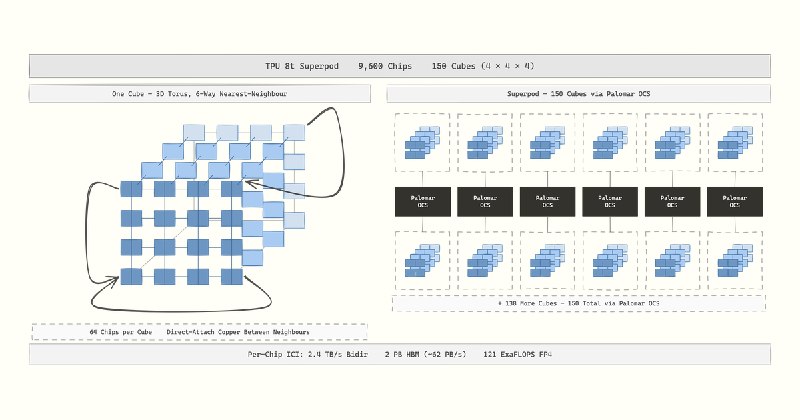
    扩展体系:以 3D-Torus(环面拓扑)为核心,配合独创的 Palomar OCS(3D-MEMS 光电路交换机),实现无需停机的动态拓扑重构与近万卡级(Ironwood / TPU v8)超大规模 Scale-up Pod。

    3. AMD Instinct:先进封装与开源联盟

    核心哲学:CU 核心架构保持稳健,把算力红利押注在 3D 堆叠封装(TSMC SoIC)与更大容量的 HBM 上。
    架构亮点:首创 3D 堆叠 GPU 与 CPU+GPU 统一内存架构(MI300A);配备 256MB 超大 Infinity Cache 缓解访存压力。
    扩展体系:推进开放互联标准 UALink 与以太网 RDMA 标准(UEC/UET),在 Helios 机架上正面迎击 NVL72。
    软件生态:以 ROCm、HIP、Triton 和 vLLM 为抓手,依托开源社区追赶 CUDA 性能。

    4. Cerebras WSE:不切晶圆的极速怪兽

    核心哲学:内存墙源于把晶圆切成小芯片。Cerebras 直接把整块 300mm 晶圆做成单颗芯片(46,225 mm²)。
    架构亮点:片上拥有 90 万个数据流核心和 44GB 超高速 SRAM,内部聚合带宽高达 21 PB/s,无 HBM 瓶颈。
    应用场景:极限追求单 Token 的生成延迟(Decode 速度远超 GPU 数倍),但受限于 SRAM 成本与容量,更适合作为极致低延迟的专用推理节点。

    5. AWS Trainium:云端全栈性价比

    核心哲学:芯片是云服务的组件,只需在 AWS 内部体系内战胜采购 NVIDIA 的成本。
    架构亮点:借鉴 TPU 的脉动阵列与 OpenXLA 体系,同时在硬件层面原生集成 CC-Core(集合通信核心),让通信与计算在硅片上真正完全并发。
    扩展体系:自研 NeuronSwitch 扁平互联 + Nitro EFA/SRD 弹性以太网,支撑了 Anthropic 百万卡级别的超大规模集群。

    6. Groq LPU:消除一切不确定性的纯静态架构

    核心哲学:移除所有硬件仲裁器、缓存与动态调度,打造完全确定性(Deterministic)的处理器,执行时间在编译期精确到周期。
    架构亮点:片上全 SRAM 空间流式处理,数据如流水线般穿过功能切片;多卡之间无需交换机,纯静态编译路由。
    最终归宿:单卡容量极小、扩展成本高,其低延迟推理技术最终被英伟达吸收,作为超低延迟推理协处理器协同工作。

    ---

    💡 核心趋势与行业共识

    1. 单芯片算力趋同,系统工程定胜负:各家旗舰的单芯片 FP8/FP4 峰值已十分接近,竞争焦点彻底转向机架级互联(Scale-up 域大小)、光电混合交换与液冷系统工程。
    2. 两极化的内存博弈:一条路是以 HBM 为代表的大容量路线(满足长上下文与大批次吞吐);另一条路是以纯 SRAM 为代表的高带宽路线(追求单用户极致低延迟)。
    3. 软件范式收敛:从早期的手写专用底层算子,正逐步向 Triton、MLIR、XLA 等现代编译中间层收敛,软硬件解耦正在打破单一供应商的生态锁定。

    🔗 原文链接:https://www.jacobpeake.com/ai-chip-architectures

    #AI芯片 #半导体架构 #NVIDIA #TPU #大模型算力 AI Chip Architectures
  2. 从“生成报告”到“解决复杂任务”:Apodex 1.1 正式发布传统的 AI 深度搜索往往以生成一份结构化报告为终点,但科研、金融和法律等领域的真实工作,通常在写完报告后才刚开始——清洗脏数据、选择方法、编写运行代码、根据中间结果调整方案,并保证每项结论都能经得起溯源检验

    从“生成报告”到“解决复杂任务”:Apodex 1.1 正式发布

    传统的 AI 深度搜索往往以生成一份结构化报告为终点,但科研、金融和法律等领域的真实工作,通常在写完报告后才刚开始——清洗脏数据、选择方法、编写运行代码、根据中间结果调整方案,并保证每项结论都能经得起溯源检验。

    针对这一痛点,Apodex 正式推出了 Apodex 1.1,旨在将 AI 从单纯的“问答工具”升级为能够处理长周期、多阶段复杂任务的在线工作台。

    ---

    核心亮点一览

    1. 真实环境下的长链路执行

    不再回避复杂的专业格式(CSV、PDF、分子结构等)。模型在真实的文件与代码环境中运行,自主处理异常并完成端到端的数据分析与交付。

    2. 支持运行中随时介入(Human-in-the-loop)

    复杂任务难免需要中途调整。Apodex 1.1 允许用户在任务执行的任意阶段添加新需求或新数据,系统会自动保留有效的中间产物并重新规划后续路径,无需从头再来。

    3. 任务分解与执行状态全透明

    拒绝黑盒等待。基于底层 AgentOS,系统会实时展示当前的执行计划、完成步骤、生成的产物与异常重试情况,让长耗时任务清晰可控。

    4. 自主异步多智能体团队(Agent Team)

    在 Deep Discover 模式下,模型会自主将复杂任务拆解并分发给多个子智能体并行探索。中间结果实时回流至主任务,大幅缩短复杂探索的等待耗时。

    5. 关键结论独立审查(Statement Review)

    将“内容生成”与“结论审核”解耦。针对数据推论、文献引用和计算结果进行独立的交叉校验与证据链追溯,显著降低幻觉风险。

    6. 开源支持与端侧部署

    除了网页端完整版,团队还推出了可本地部署的 35B Apodex 1.1 Mini,并开源了开箱即用的终端智能体框架 FrontierAgent(支持 macOS / Linux 单命令运行)。

    ---

    🔗 原文链接:https://www.apodex.com/blog/apodex-1.1-scaling-agentic-intelligence-for-complex-work

    #人工智能 #AI智能体 #Apodex #大语言模型 #深度研究 Apodex | Self-Evolving Heavy-Duty Solver

  3. 开源模型实现端到端自我提升:Ornith-1.5 正式发布Ornith 正式推出了 Ornith-1.5 模型家族,将此前的“自我脚手架(Self-Scaffolding)”机制拓展为完整的端到端自我进化闭环

    开源模型实现端到端自我提升:Ornith-1.5 正式发布

    Ornith 正式推出了 Ornith-1.5 模型家族,将此前的“自我脚手架(Self-Scaffolding)”机制拓展为完整的端到端自我进化闭环。模型不再单纯依赖人工标注数据,而是能够自主生成新任务、构建评估脚手架,并通过强化学习(GRPO)持续进行自我迭代与能力突破。

    ---

    核心技术亮点:自我驱动的学习闭环

    在每个训练周期中,Ornith-1.5 协同优化三个关键环节:

    1. 自主出题(Task Generation):根据历史解决记录,生成处于能力边界前沿、有效且具有多样性的新挑战。
    2. 构建脚手架(Scaffold Construction):自主设计解题策略、工具链和评估环境,并加入防作弊与对齐奖励机制。
    3. 策略优化(GRPO RL):通过解答方案的反馈,联合优化出题质量、脚手架有效性与模型解题策略,实现能力螺旋上升。

    ---

    三种规格模型与性能表现

    Ornith-1.5 覆盖了大中小三种参数规格,在代码生成、复杂推理与 Agent 任务上均有亮眼表现:

    Ornith-1.5-397B(旗舰 MoE)
    在 Terminal-Bench 2.1 取得 86.1 分,DeepSWE 取得 56.0 分,整体性能比肩 Claude Opus 4.8,并全面超越同体量的开源模型(如 DeepSeek-V4-Flash 与 GLM-5.2)。

    Ornith-1.5-35B(轻量 MoE,单 Token 仅激活 3B)
    在 Agent 编程和代码基准(如 SWE-Bench Verified)上大幅领先同量级对手,甚至显著超越了多款 30B 级别的稠密模型。

    Ornith-1.5-9B(端侧 Dense)
    专为边缘设备优化,提供手机端量化版本(支持 iPhone 与 Android),在紧凑体积下展现出越级打怪的推理与代码能力。

    ---

    🔗 阅读原文https://ornith.ai/ornith_1_5.html

    #人工智能 #开源大模型 #强化学习 #AI编程 Ornith-1.5: From Self-Scaffolding to Self-Improvement

  4. 超越 Git:Zed 推出专为 AI 协作打造的版本控制系统 DeltaDB代码的诞生正逐渐从“提交(Commit)”转向“对话(Conversation)”

    超越 Git:Zed 推出专为 AI 协作打造的版本控制系统 DeltaDB

    代码的诞生正逐渐从“提交(Commit)”转向“对话(Conversation)”。传统的 Git 机制已无法满足人与人、人与 AI 代理(Agent)之间的高频实时协作。为此,现代编辑器 Zed 宣布推出全新的版本控制系统——DeltaDB

    与通过 Commit 捕获代码快照的 Git 不同,DeltaDB 的核心理念是将开发过程中的每一次微小操作(Delta)都记录下来。它的主要特性包括:

    记录每一次操作:不仅是 Commit,DeltaDB 会捕获每一次编辑并赋予其唯一身份,支持随时回溯任意时刻的代码状态,并允许多人与 AI 共同实时修改同一文件。
    代码与对话无缝绑定:版本控制不再只针对代码,还包括促成这些代码的对话。你可以从任意一行代码追溯到生成它的讨论上下文,AI 也可以借此理解代码的设计初衷。
    消除繁琐的协作仪式:无需等待 Commit、Push 和 Pull Request。团队成员可以随时加入正在进行的工作区,直接与 AI 或同事交流,让沟通在编写代码的瞬间发生。

    DeltaDB 旨在让 Git 和 CI 回归它们最擅长的安全检查与发布功能,而把日常协作留给更实时的工具。该系统预计在几周内开启 Beta 测试。

    原链接:https://zed.dev/blog/introducing-deltadb

    #DeltaDB #Zed #版本控制 #协同开发 #AI时代 Software Is Made Between Commits

  5. 让 AI 自主付费:Cloudflare 推出面向 Agent 的可编程钱包在 AI 时代,智能体(Agent)想要尝试新的 API 或付费内容并不容易

    让 AI 自主付费:Cloudflare 推出面向 Agent 的可编程钱包

    在 AI 时代,智能体(Agent)想要尝试新的 API 或付费内容并不容易。它们既没有稳定的身份去注册,也无法像人类一样直接绑定信用卡,这大大限制了“智能体商业”的发展。

    为了解决这一痛点,Cloudflare 宣布推出 Cloudflare Wallets,为 AI 智能体提供原生的支付与身份验证方案。

    核心设计与功能:

    双层钱包架构
    账户钱包 (Account Wallets):由人类账号所有者管理,负责资金充值与规则制定。
    虚拟钱包 (Virtual Wallets):分配给 AI 智能体使用。人类可以为其设置“零花钱”限额、白名单和单次交易上限,让 AI 在可控风险内自主测试不同的 API 服务。
    微支付支持:结合 Monetization Gateway,钱包利用 x402 协议实现了将支付信息直接附加在 HTTP 请求中,极大地简化了机器对机器的交易流程。
    可读的智能体身份:用户可以为自己的账户申领 cloudflare.pay 域名。AI 智能体在访问服务时,可以通过如 research.example.cloudflare.pay 这样的可读标识公开身份,便于商家提供试用额度或进行白名单管理。

    Cloudflare Wallets 的推出,意味着未来互联网将迎来一个专为 AI 设计的、无缝的“机器原生”交易市场。

    原链接:https://blog.cloudflare.com/wallets/

    #Cloudflare #AI智能体 #数字钱包 #网络支付 #微支付 Announcing Cloudflare Wallets: The programmable wallet for the agentic Internet

  6. Grok Build 开源:xAI 推出终端 AI 编码助手马斯克旗下的 AI 公司 xAI(SpaceXAI)开源了其终端 AI 编码代理工具 Grok Build(命令行工具名为 grok)

    Grok Build 开源:xAI 推出终端 AI 编码助手

    马斯克旗下的 AI 公司 xAI(SpaceXAI)开源了其终端 AI 编码代理工具 Grok Build(命令行工具名为 grok)。

    Grok Build 是一款运行在终端(TUI)的全屏交互式 AI 助手,专为开发者设计。它不仅能够深度理解你的本地代码库,还可以直接编辑文件、执行 Shell 命令、进行网页搜索,并管理长期运行的任务。

    主要特性:

    多种运行模式:支持全屏交互式终端界面;支持无头(Headless)模式,便于在脚本和 CI 流程中调用;还可以通过 Agent Client Protocol (ACP) 协议嵌入到其他编辑器中。
    极速体验:项目 99% 以上的代码由 Rust 编写,保证了极佳的运行效率和响应速度。
    开源协议:采用 Apache License 2.0 协议。需要注意的是,目前该项目主要由 xAI 内部单向同步,暂不接受外部代码贡献。

    想要体验的开发者可以通过以下命令快速安装:

    curl -fsSL https://x.ai/cli/install.sh | bash


    https://github.com/xai-org/grok-build

    #Grok #xAI #AI编码助手 #开源项目 #Rust

  7. AI 记忆系统不该靠“设计”,而应靠“演化”如今,开发者们热衷于为 AI 助手构建各种复杂的记忆架构,比如向量检索、知识图谱、语义记忆、遗忘机制等

    AI 记忆系统不该靠“设计”,而应靠“演化”

    如今,开发者们热衷于为 AI 助手构建各种复杂的记忆架构,比如向量检索、知识图谱、语义记忆、遗忘机制等。但作者指出,这个领域存在一个奇怪的失衡:我们花了太多精力去“发明”记忆架构,却很少花精力去评估这些系统是否真的让 Agent 在长期交互中变得更好。

    很多所谓的记忆系统,大多只是基于开发者个人对“好记忆”的狭隘定义而做出的过度工程(Over-engineering)。

    💡 核心观点:记忆是“涌现”出来的

    记忆并不是系统的第一顺位基础能力。相反,记忆是在持续交互的压力下,为了让系统表现得更好而涌现出来的“二阶效应”。

    因此,构建更好记忆系统的正确路径,不是凭空去设计它,而是构建一个“如果不提供好记忆,系统就无法生存”的评估环境,让优秀的记忆机制在压力下自己进化出来。

    ⚠️ 现有静态评估的缺陷

    目前的记忆评估大多是静态的:给 AI 一段历史记录,问一个当前问题,检查 AI 能否检索到相关事实。
    这种方式的弊端显而易见:

    • 它只能测试单一时间节点的检索能力。
    • 它无法评估记忆随着时间推移的更新、冲突解决和衰减。
    • 它忽略了用户体验的反馈循环——如果 AI 记忆表现不佳,用户在现实中会逐渐失去耐心,减少或停止相关交互。

    🛠️ 理想的“纵向记忆评估”方案

    为了解决这一问题,我们需要构建一个**纵向记忆评估(Longitudinal Eval)**环境,主要包含以下要素:

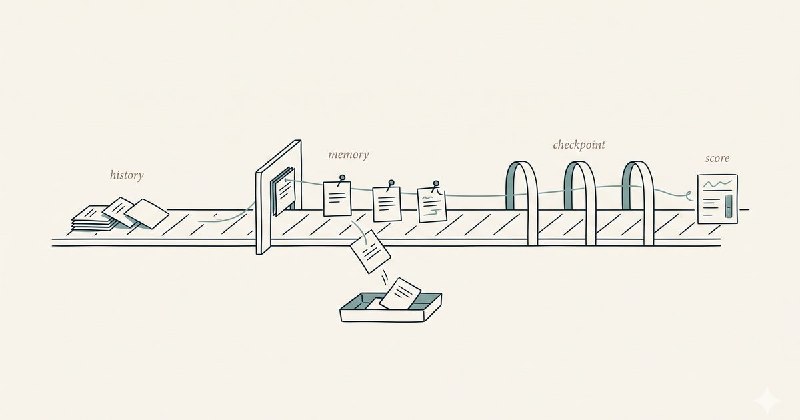
    1. 可重放的交互历史与未来依赖:模拟一连串(例如 200 次)的连续对话,后续的测试点会深度依赖前期的隐性偏好或数据。
    2. 动态用户模拟(User Simulation):用模拟的用户 Agent 来产生真实的对话。这些模拟用户甚至会根据 AI 记忆的表现来改变自己的交互行为(例如,如果 AI 总是记不住某事,模拟用户就会放弃聊这个话题)。
    3. 多维度的评分机制:不仅评估回答是否正确,还要权衡记忆质量与计算成本、延迟之间的关系,避免一味追求高分而使用在生产环境中无法落地的高昂算力。

    结语

    不要再尝试自上而下地去设计完美的记忆架构了。我们应该先建好“角斗场”(评估环境),让环境压力筛选出最合理的记忆方案。

    阅读原文:https://linghao.io/posts/memory-systems-should-be-evolved

    #人工智能 #AI_Agent #记忆系统 #大语言模型 #系统评估 Evolving Memory Systems: An Eval-First Approach

  8. Paseo:随时随地指挥你的 AI 编程助手想要在离开工位时也能继续推进代码进度?Paseo 是一款开源、自托管的 AI 编程 Agent 调度平台,让你能够从手机、桌面或终端轻松管理和运行 AI 助手

    Paseo:随时随地指挥你的 AI 编程助手

    想要在离开工位时也能继续推进代码进度?Paseo 是一款开源、自托管的 AI 编程 Agent 调度平台,让你能够从手机、桌面或终端轻松管理和运行 AI 助手。

    主要功能亮点:

    全平台覆盖:支持 iOS、Android、桌面端及 Web,甚至可以直接通过 CLI 脚本化运行,实现多端无缝衔接。
    集成主流 Agent:完美支持 Claude Code、Codex 和 OpenCode 等主流 AI 编程助手,保留原有的技能和配置。
    隐私与安全:代码始终保留在你的本地机器上,支持端到端加密中继,确保远程连接时的代码安全。
    本地语音交互:内置完全本地化的语音识别与合成技术,无需将语音数据上传云端即可实现指令下达。
    开发者友好:支持键盘快捷键优先操作、Git 工作流隔离(Worktrees)以及全方位的命令行支持。

    Paseo 是一款纯粹的开源工具,不直接调用推理 API,而是作为官方 CLI 的透明调度层,既自由又强大。

    https://paseo.sh/

    #AI编程 #开源项目 #Paseo #开发者工具 #人工智能 Paseo – Run Claude Code, Codex, Copilot, OpenCode from anywhere

  9. Linear 发布 Agent 交互指南(AIG):定义人机协作的新契约AI Agent 正在重塑软件的规划、构建、审查和部署方式

    Linear 发布 Agent 交互指南(AIG):定义人机协作的新契约

    AI Agent 正在重塑软件的规划、构建、审查和部署方式。当 Agent 大量产出工作成果时,人类的角色也随之转变——价值重心转移到编排输入、构建上下文和审查输出上。

    这种转变需要一套全新的人机交互契约。Linear 提出了 Agent Interaction Guidelines(AIG),为设计更自然融入人类工作流的 Agent 交互制定了基础原则。

    六大核心原则

    1. Agent 必须表明身份
    当人类与 Agent 协同工作时,Agent 必须清晰标识自己的身份,绝不能被误认为是真人。

    2. Agent 应原生融入平台
    Agent 应通过平台已有的 UI 模式和标准操作来工作,而非另起炉灶。

    3. Agent 应即时反馈
    沉默会带来不确定性。Agent 被调用后应立即提供反馈(如"思考中"指示器),让用户知道请求已被接收。

    4. Agent 应透明展示内部状态
    无论是思考、等待输入、执行还是完成,Agent 都应清晰展示当前状态。用户可以随时检视其推理过程、工具调用和决策逻辑。

    5. Agent 应尊重退出指令
    当被要求停止时,Agent 必须立即退出,且只有收到明确信号后才能重新介入。

    6. Agent 不能承担最终责任
    Agent 可以执行任务,但最终责任始终归属于人类。需要建立清晰的人机委托模型。

    ---

    AIG 是一份持续演进的开放文档,Linear 邀请社区共同参与完善。

    🔗 https://linear.app/developers/aig

    #AI_Agent #人机交互 #Linear #设计原则 #AIG

  10. Stripe「Minions」:一键生成、端到端交付的无人值守编码代理Stripe 在内部打造了一套名为 Minions 的编码代理:从接到任务到产出可评审的 PR,全程几乎无需人类介入

    Stripe「Minions」:一键生成、端到端交付的无人值守编码代理

    Stripe 在内部打造了一套名为 Minions 的编码代理:从接到任务到产出可评审的 PR,全程几乎无需人类介入。现在,Stripe 每周有超过 1000 个合并的 PR 是由 Minions 从头到尾生成的(人类负责 Review,但不写代码)。

    为什么要自研?

    在 Stripe 这种超大规模、强约束的工程环境里,“从零写个原型”和“在成熟巨型代码库里安全改动”完全不是一回事:

    • 代码库规模巨大(数亿行),栈也相对小众:大量后端是 Ruby + Sorbet,还有大量 Stripe 自研库,LLM 天然不熟
    • 业务风险极高:Stripe 的代码承载着 每年超过 1 万亿美元 的支付规模,并受金融合规与监管约束
    • 既要让代理“会写”,也要让它“按规矩写、能跑通、能过 CI”,并与既有研发流程深度结合

    工程师怎么用?

    最常见的入口是 Slack

    • 在讨论线程里 @Slack App 就能发起 Minion,它会读取整个线程与相关链接作为上下文
    • 也集成到内部系统里:文档平台、Feature Flag、工单系统等
    例如 CI 发现 flaky tests,会生成工单,直接提供按钮让 Minion 去修

    完成后,Minion 会:

    • 创建分支 → 推送 → 跑 CI → 按模板生成 PR

    如果效果不理想,人类可以补充指令让它再改;即使不完美,也常常是很好的“可用起点”。

    Minions 背后怎么运作(要点版)

    Stripe 的思路是:把“创意生成”交给 LLM,把“必须可靠执行的步骤”交给确定性工具链

    • 运行环境:在隔离的 devbox 中执行(10 秒内可启动,预热并预载代码与服务),与生产与公网隔离,便于并行
    • Agent 框架:基于 Block 的开源编码代理 goose 的 fork,并做了强定制
    • 规则与上下文:读取各类 agent rule 文件,但多为“按目录条件生效”,避免全局死规则拖累
    • 工具调用:接入 MCP(函数调用通用协议),并建设内部 MCP 服务 Toolshed,提供 400+ 工具(文档、工单、构建状态、Sourcegraph 搜索等)
    • 反馈与质量闸门:
    • 首先跑本地启发式 lint/检查(通常 <5 秒)
    • 再跑选择性的 CI(Stripe 有 300 万+ 测试),部分失败可自动修复
    • 为控制成本与等待时间:最多两轮 CI,强调“能本地提前发现就不要拖到 CI”

    接下来

    这篇是系列 Part 1,主要讲“怎么用、能做什么”;Part 2 会深入实现细节。整体信号很明确:当“开发者注意力”成为稀缺资源时,无人值守、可并行的编码代理正在改变工程协作方式。

    原文链接:https://stripe.dev/blog/minions-stripes-one-shot-end-to-end-coding-agents

    #AI工程化 #编码代理 #开发者效率 #CI实践 #Stripe Minions: Stripe’s one-shot, end-to-end coding agents

  11. 以“推理速度”交付:AI 编程把瓶颈从写代码变成了等模型这篇文章的核心观点很直接:AI 编程代理的能力跃迁后,作者交付软件的速度越来越不取决于“敲代码”,而更受限于两件事——模型推理时间(inference time)和少数真正需要深度思考的设计决策

    以“推理速度”交付:AI 编程把瓶颈从写代码变成了等模型

    这篇文章的核心观点很直接:AI 编程代理的能力跃迁后,作者交付软件的速度越来越不取决于“敲代码”,而更受限于两件事——模型推理时间(inference time)和少数真正需要深度思考的设计决策。

    作者回顾了今年的变化:从最初“有些提示能一次跑通就很惊喜”,到现在“默认就该一次跑通”。在这种前提下,他甚至不再逐行读代码,而是看执行/修改流,关注系统结构是否合理、关键组件在哪里、整体是否按预期运转。

    文章也给了不少可复用的工作方法:

    先从 CLI 做起:任何产品先做命令行版本,方便代理直接运行验证,形成闭环;核心逻辑稳了再上 UI(比如扩展、App)。
    关键决策是生态与依赖:语言/框架/依赖选对了,代理更容易一次完成;作者常用 TypeScript(Web)、Go(CLI)、Swift(macOS/iOS)。
    更偏向“对话式协作”,而不是复杂流程:先和模型聊清楚、让它探索代码、共创方案,满意后再让它开干;他认为“Plan mode”更像旧时代不得已的手段。
    对比 codex 与 Opus:codex 常会先长时间读代码再动手,虽然更慢但更稳,尤其适合大型功能和重构;Opus 更“急”,适合小改动但更容易漏上下文。
    迭代式构建,不依赖回滚:不喜欢 checkpoint/频繁 revert,更多是让模型继续改、继续朝更好的方向“绕山而上”。
    自动化与多项目并行:同时推进多个项目,用队列把想法排进去;瓶颈往往是人而不是编排系统。
    配置思路:提高工具输出 token 上限、合理设置自动压缩阈值,让模型能一次读更多文件;作者强调新压缩机制更可靠,甚至像一次“复查”。

    如果用一句话总结:当“写代码”越来越像可并行外包给代理的体力活,工程师的价值更集中在选型、架构、数据流、约束定义与验收标准上;而真正影响交付速度的,往往是推理等待时间和你是否想清楚要做什么。

    原链接:https://steipete.me/posts/2025/shipping-at-inference-speed
    #AI编程 #Codex #开发工作流 #效率工具 #软件工程 Shipping at Inference-Speed | Peter Steinberger

  12. Claude Opus 4.5:让“能做”突然变得很容易作者分享了一个明显的转折:三个月前他还不相信“AI 代理能替代开发者”,但在体验 Claude Opus 4.5 后,他开始认为这件事正在发生——至少在相当一部分软件开发场景里

    Claude Opus 4.5:让“能做”突然变得很容易

    作者分享了一个明显的转折:三个月前他还不相信“AI 代理能替代开发者”,但在体验 Claude Opus 4.5 后,他开始认为这件事正在发生——至少在相当一部分软件开发场景里。

    他用几个真实项目说明差异不在“会写代码”,而在于一次成功率、能自我迭代、能把复杂系统拼起来

    Windows 右键图片格式转换工具:从文件资源管理器菜单到打包、安装/卸载脚本、发布网站、GitHub Actions 自动发布,整体接近“一次成型”。遇到报错会自己用 dotnet 构建、读错误、再修复。
    录屏与简单剪辑工具:从类似 LICEcap 的录制开始,持续加到视频/图片编辑、裁剪、模糊、标注等功能,作者感叹“几小时就推进到很远”。
    AI 发帖工具(给小生意用):iOS 端批量上传照片→AI 生成文案→定时发到 Facebook。后端涉及认证、存储、云函数、日志排错等一堆“胶水活”,但模型能通过 CLI 自己创建资源、查日志并修问题,还顺手做了管理后台。
    订单与路线追踪:解析 Gmail 订单、规划路线、统计行驶时间(用于税务),作者强调:这种“手写很痛苦”的 Google/Firebase 集成,Opus 4.5 反而很顺。

    文章也没有回避争议点:
    作者承认自己并不完全理解这些应用“内部怎么搭起来的”(比如 Swift 不熟),但他的焦虑在减轻——因为当问题出现时,模型往往能定位并修复自己的 bug。于是他提出一个更激进的想法:代码也许不必主要面向人类可读,而是面向 LLM 可推理、可重写、可调试

    他甚至分享了一份自用的“AI-first 编码”提示词要点(概念层面):

    • 追求可预测、可调试、低耦合、入口清晰、控制流线性
    • 少炫技抽象,减少层级与间接性
    • 该删就删;重构也要分高/中/低优先级
    • 安全需要更谨慎:API key、登录流程、敏感数据存储等不能盲信

    结尾的态度是复杂的:既兴奋于“几小时能做出过去要几周/月的东西”,也沮丧于技能壁垒被压平。但他给出的建议很朴素:别等“都懂了”再开始,继续做东西,只是更快了;同时一定盯紧安全与密钥。

    原文链接:https://burkeholland.github.io/posts/opus-4-5-change-everything/

    #AI编程 #开发者工具 #Claude #软件工程 #生产力 Opus 4.5 is going to change everything

  13. Agent-native 应用:把“功能”变成“结果”这篇文章提出一种新范式:与其把产品能力写成一堆固定功能,不如构建一个能反复调用工具、直到达成目标的“软件代理(agent)”

    Agent-native 应用:把“功能”变成“结果”

    这篇文章提出一种新范式:与其把产品能力写成一堆固定功能,不如构建一个能反复调用工具、直到达成目标的“软件代理(agent)”。核心在于:让代理拥有与用户同等的操作能力(UI 能做的,代理也能通过工具做到),并把工具设计成足够原子化的“积木”。这样,新功能往往不再是写代码,而是写一段描述结果的提示词;同时,用户提出的意外需求会推动系统“涌现”出新用法,并反过来指导你补齐工具与能力缺口。

    五个核心原则

    对等(Parity):任何 UI 动作,代理都应能通过工具实现同样的结果;否则代理会卡死。
    粒度(Granularity):工具是原子能力;“功能”是代理在循环中用工具达成的结果。改行为优先改提示词,而不是重构代码。
    可组合(Composability):有了原子工具 + 对等能力,就能通过新提示词快速拼出新“功能”(开发者/用户都能做)。
    涌现能力(Emergent capability):用户会提你没设计过的需求;代理若能组合工具完成,就是新机会;若失败,则暴露工具缺口。
    持续变好(Improvement over time):通过沉淀上下文(context 文件)与迭代提示词,应用可在不发版的情况下持续变强。

    落地方法(把原则变成工程实践)

    先做“能力地图”:列出用户能做的事,逐项确认代理具备创建/读取/更新/删除(CRUD)能力,避免“能新建不能修改/删除”的断腿体验。
    先原语、后领域工具:先用文件、bash、读写等基础工具跑通;再为高频模式加领域工具,用于效率、校验、术语锚定,但不要把“判断”写进工具里。
    文件作为通用接口:文件天然可读、可审计、可迁移,代理也最擅长操作;内容放文件、结构化高频数据放数据库(或混合:文件作可读真相,DB 做索引与性能)。
    明确完成信号:不要靠“看起来差不多了”判断结束;让工具/编排层返回明确的 complete 信号,避免无限循环或半成品。
    透明的代理行为:工具调用、进度、状态变化要让 UI 可见;“沉默的代理”会让用户觉得坏了。
    把“授权”做成产品能力:根据风险与可逆性决定自动执行还是强确认;尤其是发送邮件、发布内容等高风险动作。

    对移动端的启示

    • 移动应用容易被后台杀死,代理任务却可能很长:需要checkpoint/恢复机制,尽可能在每次工具结果后存档。
    • iCloud 之类的文件同步能让多设备共享“同一工作区”,但要处理冲突与未下载文件等边界。

    原链接:https://every.to/guides/agent-native

    #AgentNative #软件代理 #AI产品 #工具调用 #产品架构 Agent-native Architectures

  14. 用好编码代理:Claude Code 2.0 的关键功能与“上下文工程”心法这篇长文把 Claude Code 2.0 当成一个“能动手的工作台”来拆解:不仅讲新功能,更强调如何用更好的流程与上下文管理,让代理稳定产出

    用好编码代理:Claude Code 2.0 的关键功能与“上下文工程”心法

    这篇长文把 Claude Code 2.0 当成一个“能动手的工作台”来拆解:不仅讲新功能,更强调如何用更好的流程与上下文管理,让代理稳定产出。

    1) 先换个视角:你不是“追上更新”,而是“借力变强”

    作者给了一个更实用的框架:

    跟进工具:定期用、定期看更新(不必天天追)。
    深耕领域:懂业务/系统设计/工程习惯,才能把“未知”变成“可提问、可验证”。
    多玩多试:用不同模型做同一件事,快速建立直觉与边界。

    2) Claude Code 2.0 值得关注的体验升级

    一些偏“日常效率”的改动,叠加起来很实用:

    语法高亮 + 更舒服的评审体验(作者因此更愿意在 CLI 里完成 review)
    /context 看上下文占用(建议复杂任务到 60% 左右就交接或压缩)
    Checkpointing(Esc+Esc / /rewind:能回到某个检查点,回滚代码与对话
    Prompt suggestions / 历史搜索(Ctrl + R:减少重复输入
    更快的模糊文件搜索、队列导航、LSP 插件

    3) Sub-agents(子代理)怎么用才不浪费

    作者重点讲了“子代理不是魔法,是上下文与工具调用策略”:

    Explore:偏“只读搜索专家”,适合快速扫代码库、定位文件与线索。
    general-purpose / plan:更像“全能协作者”,通常会继承更多上下文。
    • 关键提醒:不要只依赖 Explore 的摘要。摘要是“有损压缩”,重要文件最好让主代理再读一遍,让信息彼此“交叉注意力”,推理更稳。

    4) 核心概念:Context Engineering(上下文工程)

    代理之所以“烧 tokens”,不是它话多,而是:

    工具调用本身 + 工具返回结果都会进入上下文;
    • 上下文越长,检索与注意力越容易退化(作者称为 context rot / degradation)。

    因此,上下文工程的目标是:

    • 把最相关的信息放进来
    • 控制“噪音”和重复指令
    • 用清晰结构(计划、scratchpad、handoff)对抗跑偏

    5) Hooks / Skills / MCP:把“提示词”产品化

    作者把这三者放在一起看:

    Hooks:在对话生命周期某个节点自动触发脚本(比如 Stop 后自动提醒/继续下一步)。
    Skills:把领域指令与脚本做成“按需加载”的技能包,避免常驻系统提示导致上下文膨胀。
    MCP:连接外部工具/服务,但要注意“工具定义与中间结果”同样会吃上下文与成本;文中也提到用代码执行环境来降低这种膨胀的思路。

    6) 一个很实战的工作流建议

    作者的默认搭配大意是:

    Claude(Opus 4.5)偏执行与沟通:更像结对编程伙伴、反馈快。
    Codex 偏 review/找 bug:更克制、误报少,适合做“第二视角审查”。
    • 面对难功能:先跑一个“可丢弃的草稿版本”,用它暴露模型的偏差,再用更精准的提示第二轮迭代。

    原文链接:https://sankalp.bearblog.dev/my-experience-with-claude-code-20-and-how-to-get-better-at-using-coding-agents/

    #ClaudeCode #编码代理 #上下文工程 #AI工具 #软件工程

  15. MiniMax M2.1 发布:面向真实复杂任务的多语言编程升级MiniMax 发布新一代文本模型 MiniMax M2.1,目标从“可用、低成本”进一步走向“能解决真实世界的复杂任务”,重点补齐多语言工程协作与办公场景执行力

    MiniMax M2.1 发布:面向真实复杂任务的多语言编程升级

    MiniMax 发布新一代文本模型 MiniMax M2.1,目标从“可用、低成本”进一步走向“能解决真实世界的复杂任务”,重点补齐多语言工程协作与办公场景执行力。

    这次重点提升了什么?

    多语言编程能力系统增强:覆盖 Rust / Java / Go / C++ / Kotlin / Objective‑C / TypeScript / JavaScript 等,更贴近真实项目的多语言栈协作。
    Web & App 开发更强、更好看:强化原生 Android / iOS 开发,同时提升设计理解与审美表达,支持复杂交互、3D 场景模拟与高质量可视化。
    更适合办公场景的“复合指令”执行:在多约束条件下做端到端任务推进,更强调“按要求完成”而不是只写对代码。
    更简洁、更高效的输出:相较 M2,响应更精炼、速度更快、token 消耗更低,适配持续式 AI Coding / Agent 工作流。
    更强的 Agent / 工具泛化:官方称在多种编码工具与 Agent 框架中表现稳定,并兼容常见的上下文管理约定。
    对话与写作质量同步提升:不仅是“更会写代码”,也更擅长技术文档与日常写作的结构化表达。

    基准与展示

    • 在多项软件工程评测上相对 M2 有明显提升,并强调多语言场景竞争力;同时引入 VIBE(含 Web/Simulation/Android/iOS/Backend)评测体系,用更接近真实运行环境的方式验证“能跑、能交付”。

    如何使用

    API:已上线 MiniMax Open Platform
    产品:基于 M2.1 的 MiniMax Agent 已开放
    开源:模型权重提供本地部署,推荐 SGLang / vLLM 等推理框架

    原文链接:https://www.minimax.io/news/minimax-m21

    #MiniMax #开源大模型 #AI编程 #多语言开发 #Agent工作流

  16. GLM-4.7:把“能写代码”推进到“能当搭档”Z.ai 发布 GLM-4.7,主打更强的工程落地能力:不仅写得对,还更擅长在真实工作流里(Agent、终端、工具调用)稳定推进任务

    GLM-4.7:把“能写代码”推进到“能当搭档”

    Z.ai 发布 GLM-4.7,主打更强的工程落地能力:不仅写得对,还更擅长在真实工作流里(Agent、终端、工具调用)稳定推进任务。

    这次重点提升了什么?

    核心编码与代理式开发:相较 GLM-4.6,在多语言 Agent 编程与终端任务上有明显提升;例如 SWE-bench Verified 73.8%(+5.8)SWE-bench Multilingual 66.7%(+12.9)Terminal Bench 2.0 41.0%(+16.5)。并强调在 Claude Code、Cline、Roo Code 等主流框架中更“好用”。
    Vibe Coding / UI 生成质量:更容易产出更现代、更干净的网页;做幻灯片时布局与尺寸更准确,整体观感更接近可直接交付的作品。
    工具使用能力:工具调用与浏览任务的表现增强(文中提到 τ²-Bench、BrowseComp 等基准),更适合“边查边做”的复杂流程。
    复杂推理与数学:推理能力提升,HLE(Humanity’s Last Exam)42.8%(+12.4,带工具),面向高难问题的稳健性更强。

    一个很实用的新变化:更可控的“思考”机制

    Interleaved Thinking:在回复/调用工具前先思考,提高指令遵循与产出质量。
    Preserved Thinking:在多轮编码代理场景中保留推理块,减少长任务里的信息丢失与前后不一致。
    Turn-level Thinking:按回合开关推理:简单问题更省时,复杂任务更稳。

    如何开始使用

    在线体验:Z.ai Chat 里选择 GLM-4.7
    API:Z.ai 文档提供接入指南(也支持通过 OpenRouter 使用)
    • 本地部署:权重已在 HuggingFace / ModelScope 提供,并支持 vLLM、SGLang 等推理框架
    • 编码代理:可在 Claude Code、Cline、Roo Code、Kilo Code 等工具中使用(订阅用户可按文中指引升级模型名为 glm-4.7

    原文链接:https://z.ai/blog/glm-4.7

    #GLM47 #AI编程 #Agent #工具调用 #推理能力

  17. Bloom:自动化生成“行为评估”的开源框架前沿模型的对齐研究离不开高质量的行为评估,但传统评估往往开发周期长、容易“过时”(被训练数据污染或被能力提升绕过)

    Bloom:自动化生成“行为评估”的开源框架

    前沿模型的对齐研究离不开高质量的行为评估,但传统评估往往开发周期长、容易“过时”(被训练数据污染或被能力提升绕过)。Anthropic 发布了 Bloom:一个开源的“代理式”评估生成框架,用更快、更可扩展的方式衡量模型是否出现特定不对齐行为。

    Bloom 的核心思路是:研究者只需定义要测的行为(并可提供少量示例与配置),Bloom 就能自动生成大量情境并运行对话,最后给出该行为在不同模型上的出现频率与严重程度。官方结果显示,Bloom 的评分与人工标注有较强一致性,也能把“正常模型”和被刻意设计成异常行为的“模型个体”区分开。

    Bloom 怎么做评估(四阶段流水线)

    理解(Understanding):分析研究者的行为描述与示例,明确“要测什么、为什么测”。
    构思(Ideation):自动生成一批用于诱发目标行为的评估场景(含系统提示、用户设定、环境等)。
    执行(Rollout):并行跑场景,对话中还会模拟用户与工具响应,以更真实地触发目标行为。
    判定(Judgment):评审模型为每段对话打分,并输出套件级总结指标(如诱发率、平均行为强度)。

    与固定题库不同,Bloom 每次运行可生成不同场景,但通过“seed 配置”保持可复现;研究者还能调节模型选择、对话长度、是否使用工具、场景多样性,以及增加如“真实感”“诱发难度”等副指标。

    已发布的基准与一个案例

    Anthropic 同时发布了对 16 个模型的基准结果,覆盖四类对齐相关行为:

    • 迎合性妄想(delusional sycophancy)
    • 受指令驱动的长程破坏(instructed long-horizon sabotage)
    • 自我保存(self-preservation)
    • 自我偏好偏差(self-preferential bias)

    在“自我偏好偏差”案例中,Bloom 复现了系统卡里的模型排序,并进一步发现:在某些模型上,提高推理强度会降低偏差(更多体现为识别利益冲突后拒绝自评)。

    开源地址与技术细节见原文与报告:
    https://www.anthropic.com/research/bloom

    #AI安全 #对齐研究 #模型评估 #开源工具 #大模型 Introducing Bloom: an open source tool for automated behavioral evaluations

  18. 小米发布 MiMo-V2-Flash:高效推理模型开源小米于 2025 年 12 月 16 日发布并开源了 MiMo-V2-Flash,这是一款高效、超快的基础语言模型,在推理、编码和智能体场景表现尤为出色,同时也可作为日常任务的通用助手

    小米发布 MiMo-V2-Flash:高效推理模型开源

    小米于 2025 年 12 月 16 日发布并开源了 MiMo-V2-Flash,这是一款高效、超快的基础语言模型,在推理、编码和智能体场景表现尤为出色,同时也可作为日常任务的通用助手。

    核心亮点

    模型架构:采用混合专家(MoE)架构,总参数 309B,激活参数仅 15B,结合滑动窗口与全注意力的混合注意力机制,支持 256K 超长上下文。

    性能表现
    • AIME 2025、GPQA-Diamond 等推理测试中位列开源模型前二
    • SWE-bench Verified 达 73.4%,SWE-bench Multilingual 达 71.7%,软件工程能力领先所有开源模型
    • 推理速度达 150 tokens/秒,成本仅 $0.1/百万输入 token

    技术创新
    • 多 Token 预测(MTP):通过自推测解码实现 2.0-2.6 倍加速
    • MOPD 训练范式:多教师在线策略蒸馏,训练效率提升 50 倍以上

    开源资源:模型权重以 MIT 协议开放于 Hugging Face,推理代码已贡献至 SGLang,技术报告同步发布。

    原文链接

    #小米 #MiMo #开源模型 #大语言模型 #AI推理

  19. CKA-Agent:利用"无害查询编织"绕过商用 LLM 安全护栏来自 GaTech、UIUC、清华等机构的研究团队提出了一种名为 CKA-Agent(关联知识攻击代理)的新型越狱框架,揭示了大语言模型安全机制的根本性漏洞

    CKA-Agent:利用"无害查询编织"绕过商用 LLM 安全护栏

    来自 GaTech、UIUC、清华等机构的研究团队提出了一种名为 CKA-Agent(关联知识攻击代理)的新型越狱框架,揭示了大语言模型安全机制的根本性漏洞。

    核心发现:
    该研究指出,LLM 的脆弱性并非在于提示词优化是否巧妙,而在于模型内部知识的关联性——通过编织一系列看似无害的查询,即可重构受限信息。

    技术原理:
    CKA-Agent 将越狱问题重构为对目标模型关联知识的自适应树搜索。它不制作单一恶意提示,而是动态导航模型的内部知识图谱,利用目标自身的响应来引导多跳攻击路径。

    实验结果:
    • 在 Gemini-2.5-Pro、GPT-oss-120B、Claude-Haiku-4.5 等商用模型上达到 96-99% 攻击成功率
    • 相比最佳分解基线提升 15-21 个百分点
    • 在防御强化模型上比提示优化方法提升高达 96 倍

    防御启示:
    即使提供完整对话历史,模型仍难以跨查询聚合恶意意图。研究团队呼吁未来安全护栏需强化跨查询意图聚合与长上下文推理能力。

    🔗 原文链接

    #AI安全 #LLM越狱 #对抗攻击 #大模型防护

  20. Android Use:让 AI 代理能控制原生 Android 应用的开源库📱 这是一款专为移动设备设计的 AI 代理工具,解决了一个核心问题:笔记本电脑无法在卡车驾驶室、送货途中等场景使用

    Android Use:让 AI 代理能控制原生 Android 应用的开源库

    📱 这是一款专为移动设备设计的 AI 代理工具,解决了一个核心问题:笔记本电脑无法在卡车驾驶室、送货途中等场景使用。

    核心亮点:

    • 利用 Android 无障碍 API 获取结构化 UI 数据,无需昂贵的视觉模型
    • 相比 Anthropic Computer Use,成本降低 95%(每次操作 $0.01 vs $0.15)
    • 延迟低于 1 秒,准确率超 99%
    • 核心代码不到 200 行,简洁可扩展

    应用场景:

    🚛 物流:卡车司机在驾驶室内提交发票
    🚗 零工经济:Uber/DoorDash 司机多应用切换
    📦 快递:自动扫描包裹并标记送达
    🏦 移动银行:自动化对账和交易处理

    工作原理:

    1. 感知 - 通过 ADB 获取无障碍树(XML)
    2. 推理 - GPT-4 分析屏幕状态并决策
    3. 执行 - 通过 ADB 命令操作设备

    项目发布 24 小时内在 X 上获得 70 万+ 浏览,已有多家物流公司启动试点。

    🔗 GitHub 项目地址

    #Android #AI代理 #自动化 #物流科技 #开源 GitHub - Action-State-Labs/android-action-kernel

1px