Search: #人机交互

  1. 别再死磕终端界面了:AI 时代,我们该重新拥抱原生 GUI长久以来,开发者群体对终端(CLI)与终端图形界面(TUI)有着近乎执念的情怀

    别再死磕终端界面了:AI 时代,我们该重新拥抱原生 GUI

    长久以来,开发者群体对终端(CLI)与终端图形界面(TUI)有着近乎执念的情怀。我们习惯了用 ASCII 字符画窗口,忍受终端里生硬的滚动、选词和无障碍支持。但资深安全研究员与开发者 Thomas Ptacek 近日撰文直言:是时候停止编写新的 TUI,全面转向原生图形界面(Native GUI)了。

    为什么我们曾执着于 TUI?

    作者指出,CLI(命令行接口)具备不可替代的组合能力,永远不会过时;但 TUI(终端用户界面,如借助 Curses、Ratatui 等构建的字符界面)本质上是 70 年代哑终端与调制解调器时代的产物。开发者之所以青睐 TUI,往往不是因为终端天生更优越,而是过去开发原生 GUI 的学习成本和琐碎代码实在令人望而却步。

    在终端里,开发者需要费尽心思去模拟原生控件早已完美实现的基础特性:平滑滚动、拖放交互、多窗口浮动、图片渲染以及无障碍(a11y)支持。

    AI 彻底打破了原生 GUI 的门槛

    以往编写 SwiftUI、GTK 或 WinUI 需要掌握大量繁重的平台细节,但现在通过 Claude、Codex 等 AI Agent,构建原生界面的难度被降到了极低:

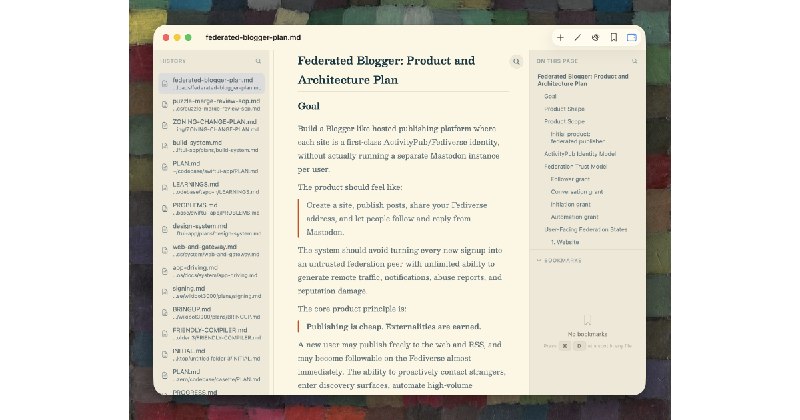
    • 作者在几乎没有手写 UI 代码的情况下,快速“召唤”出了一批自用原生 Mac 工具:Markdown 渲染器、SageMath 公式计算器、基于 SQLite 的 AI 音乐播放器、状态栏遥控器等。
    • 原生框架天生具备一致的设计语言、流畅的交互与完善的语义无障碍树,开发体验与最终成品质量远胜在终端中“打补丁”。

    驳斥几个常见的 TUI 迷思

    1. “TUI 信息密度高、键盘流效率高”:GUI 同样可以做到极高密度和纯键盘操作(如彭博终端),只是以往少有人专门为 Geek 定制。
    2. “TUI 方便 SSH 远程管理”:生产环境真正需要的是健壮的 CLI,完全可以由本地原生客户端(类似 Emacs TRAMP 的模式)来驱动远程交互。
    3. “TUI 更轻量、跨平台”:如果是为了自己顺手打造的小工具,为兼顾跨平台而牺牲全部交互体验并不划算。

    结语
    AI 正在消除前后端与图形界面的开发鸿沟。如果你依然习惯于把自用工具限制在黑黢黢的终端字符里,不妨尝试让 AI 为你的小脚本生成一个原生 GUI——这很可能会彻底改变你与计算机交互的方式。

    https://sockpuppet.org/blog/2026/08/20/stop-making-tuis/

    #软件开发 #原生应用 #SwiftUI #TUI #人工智能 Stop Making TUIs
  2. AI 记忆系统不该靠“设计”,而应靠“演化”如今,开发者们热衷于为 AI 助手构建各种复杂的记忆架构,比如向量检索、知识图谱、语义记忆、遗忘机制等

    AI 记忆系统不该靠“设计”,而应靠“演化”

    如今,开发者们热衷于为 AI 助手构建各种复杂的记忆架构,比如向量检索、知识图谱、语义记忆、遗忘机制等。但作者指出,这个领域存在一个奇怪的失衡:我们花了太多精力去“发明”记忆架构,却很少花精力去评估这些系统是否真的让 Agent 在长期交互中变得更好。

    很多所谓的记忆系统,大多只是基于开发者个人对“好记忆”的狭隘定义而做出的过度工程(Over-engineering)。

    💡 核心观点:记忆是“涌现”出来的

    记忆并不是系统的第一顺位基础能力。相反,记忆是在持续交互的压力下,为了让系统表现得更好而涌现出来的“二阶效应”。

    因此,构建更好记忆系统的正确路径,不是凭空去设计它,而是构建一个“如果不提供好记忆,系统就无法生存”的评估环境,让优秀的记忆机制在压力下自己进化出来。

    ⚠️ 现有静态评估的缺陷

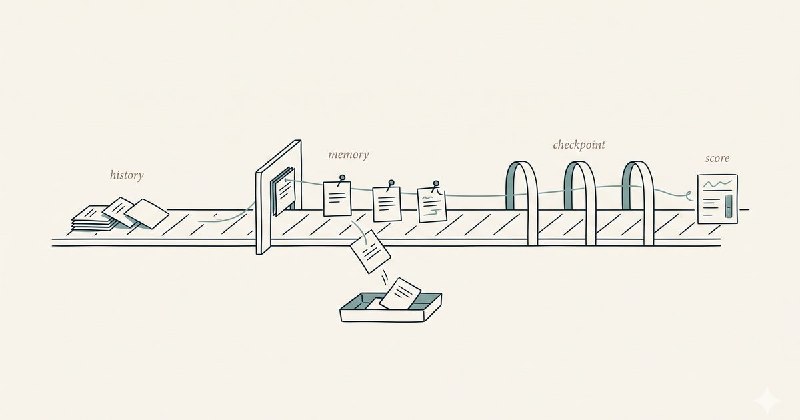
    目前的记忆评估大多是静态的:给 AI 一段历史记录,问一个当前问题,检查 AI 能否检索到相关事实。
    这种方式的弊端显而易见:

    • 它只能测试单一时间节点的检索能力。
    • 它无法评估记忆随着时间推移的更新、冲突解决和衰减。
    • 它忽略了用户体验的反馈循环——如果 AI 记忆表现不佳,用户在现实中会逐渐失去耐心,减少或停止相关交互。

    🛠️ 理想的“纵向记忆评估”方案

    为了解决这一问题,我们需要构建一个**纵向记忆评估(Longitudinal Eval)**环境,主要包含以下要素:

    1. 可重放的交互历史与未来依赖:模拟一连串(例如 200 次)的连续对话,后续的测试点会深度依赖前期的隐性偏好或数据。
    2. 动态用户模拟(User Simulation):用模拟的用户 Agent 来产生真实的对话。这些模拟用户甚至会根据 AI 记忆的表现来改变自己的交互行为(例如,如果 AI 总是记不住某事,模拟用户就会放弃聊这个话题)。
    3. 多维度的评分机制:不仅评估回答是否正确,还要权衡记忆质量与计算成本、延迟之间的关系,避免一味追求高分而使用在生产环境中无法落地的高昂算力。

    结语

    不要再尝试自上而下地去设计完美的记忆架构了。我们应该先建好“角斗场”(评估环境),让环境压力筛选出最合理的记忆方案。

    阅读原文:https://linghao.io/posts/memory-systems-should-be-evolved

    #人工智能 #AI_Agent #记忆系统 #大语言模型 #系统评估 Evolving Memory Systems: An Eval-First Approach

  3. 大语言模型(LLM)是如何运作的?一文拆解它的底层逻辑从 GPT、Claude 到 LLaMA,大语言模型看似无所不知,但其背后的技术大多高度收敛于 Transformer 架构

    大语言模型(LLM)是如何运作的?一文拆解它的底层逻辑

    从 GPT、Claude 到 LLaMA,大语言模型看似无所不知,但其背后的技术大多高度收敛于 Transformer 架构。本文为你快速拆解 LLM 运行的 6 个核心步骤:

    1. 分词与嵌入(Tokenization & Embeddings)
    模型不直接阅读文本。你的输入首先会被拆解为子词 Token,并转化为数字 ID。随后,这些 ID 通过“嵌入矩阵”变成高维向量。在向量空间中,语义相近的词(如“猫”和“狗”)会被分配到相邻的位置,从而获得“语义”。

    2. 位置编码(Positional Encoding)
    普通的注意力机制无法分辨词序。现代模型主要使用 RoPE(旋转位置编码),通过旋转向量来标记 Token 之间的相对距离,让模型知道哪个词在前,哪个词在后。

    3. 注意力机制(Attention & Multi-Head)
    这是 Transformer 的灵魂。每个 Token 会通过 Query(寻找什么)、Key(匹配什么)和 Value(传递什么)三种角色与其他 Token 进行信息交互。为了同时捕捉语法、代词指代等多种关系,模型会并行运行多个注意力“头”。现代模型多采用 GQA(分组查询注意力) 来大幅降低显存占用。

    4. 前馈网络(FFN & MoE)
    如果说注意力机制是 Token 之间的“对话”,前馈网络就是 Token 的“自我思考”。模型的大部分 factual 记忆都存储在这里。为了在不增加计算成本的前提下扩大参数量,现代大模型(如 Mixtral)常使用 MoE(混合专家模型),每次只激活部分网络来处理 Token。

    5. 残差流与归一化(Residual Stream & RMSNorm)
    随着网络层数变深,信号容易衰减或爆炸。残差连接允许原始信息绕过部分计算直接向后传递,而 RMSNorm 则在每层计算前对数据进行重缩放,确保数百层的网络能够稳定训练。

    6. 预测下一个 Token(Next-Token Prediction)
    LLM 的本质是一个“词语接龙”游戏。模型在最后一层输出所有候选词的概率分布,根据设定的“温度(Temperature)”等参数抽取下一个 Token,并将其拼回输入,循环往复,直到生成完整文本。

    总结来说,如今的 LLM 架构在工程上已经高度趋同(RoPE、GQA、SwiGLU、RMSNorm 的组合)。不同模型之间的差异,主要源于训练数据集、参数规模以及后期的对齐微调(RLHF)。

    阅读完整英文博文:https://www.0xkato.xyz/how-llms-actually-work/

    #大语言模型 #Transformer #人工智能 #深度学习 #技术科普

  4. Paseo:随时随地指挥你的 AI 编程助手想要在离开工位时也能继续推进代码进度?Paseo 是一款开源、自托管的 AI 编程 Agent 调度平台,让你能够从手机、桌面或终端轻松管理和运行 AI 助手

    Paseo:随时随地指挥你的 AI 编程助手

    想要在离开工位时也能继续推进代码进度?Paseo 是一款开源、自托管的 AI 编程 Agent 调度平台,让你能够从手机、桌面或终端轻松管理和运行 AI 助手。

    主要功能亮点:

    全平台覆盖:支持 iOS、Android、桌面端及 Web,甚至可以直接通过 CLI 脚本化运行,实现多端无缝衔接。
    集成主流 Agent:完美支持 Claude Code、Codex 和 OpenCode 等主流 AI 编程助手,保留原有的技能和配置。
    隐私与安全:代码始终保留在你的本地机器上,支持端到端加密中继,确保远程连接时的代码安全。
    本地语音交互:内置完全本地化的语音识别与合成技术,无需将语音数据上传云端即可实现指令下达。
    开发者友好:支持键盘快捷键优先操作、Git 工作流隔离(Worktrees)以及全方位的命令行支持。

    Paseo 是一款纯粹的开源工具,不直接调用推理 API,而是作为官方 CLI 的透明调度层,既自由又强大。

    https://paseo.sh/

    #AI编程 #开源项目 #Paseo #开发者工具 #人工智能 Paseo – Run Claude Code, Codex, Copilot, OpenCode from anywhere

  5. Linear 发布 Agent 交互指南(AIG):定义人机协作的新契约AI Agent 正在重塑软件的规划、构建、审查和部署方式

    Linear 发布 Agent 交互指南(AIG):定义人机协作的新契约

    AI Agent 正在重塑软件的规划、构建、审查和部署方式。当 Agent 大量产出工作成果时,人类的角色也随之转变——价值重心转移到编排输入、构建上下文和审查输出上。

    这种转变需要一套全新的人机交互契约。Linear 提出了 Agent Interaction Guidelines(AIG),为设计更自然融入人类工作流的 Agent 交互制定了基础原则。

    六大核心原则

    1. Agent 必须表明身份
    当人类与 Agent 协同工作时,Agent 必须清晰标识自己的身份,绝不能被误认为是真人。

    2. Agent 应原生融入平台
    Agent 应通过平台已有的 UI 模式和标准操作来工作,而非另起炉灶。

    3. Agent 应即时反馈
    沉默会带来不确定性。Agent 被调用后应立即提供反馈(如"思考中"指示器),让用户知道请求已被接收。

    4. Agent 应透明展示内部状态
    无论是思考、等待输入、执行还是完成,Agent 都应清晰展示当前状态。用户可以随时检视其推理过程、工具调用和决策逻辑。

    5. Agent 应尊重退出指令
    当被要求停止时,Agent 必须立即退出,且只有收到明确信号后才能重新介入。

    6. Agent 不能承担最终责任
    Agent 可以执行任务,但最终责任始终归属于人类。需要建立清晰的人机委托模型。

    ---

    AIG 是一份持续演进的开放文档,Linear 邀请社区共同参与完善。

    🔗 https://linear.app/developers/aig

    #AI_Agent #人机交互 #Linear #设计原则 #AIG

1px