面条的草稿箱

  1. 如何对 AI 更有“野心”?一位 Claude 开发者的实用指南很多时候,限制 AI 发挥上限的并不是模型本身,而是我们对任务的想象力

    如何对 AI 更有“野心”?一位 Claude 开发者的实用指南

    很多时候,限制 AI 发挥上限的并不是模型本身,而是我们对任务的想象力。在大多数人还在让 AI 改写邮件、生成模板 PPT 时,Anthropic 的 Claude 开发者 Felix Rieseberg 分享了一份“野心指南”,教我们如何摆脱浅层用法,真正释放大模型的生产力潜能。

    他将使用 AI 的“野心”拆解为四个维度,其中三个最值得深入实践:

    1. 提升“高度”(Altitude):从交待动作,到追求最终结果

    不要只让模型完成细碎的微观任务,试着让它在更高的抽象层级上思考:

    • 思考目标背后的目标:以前是让 AI 修复一个 Bug,现在可以试着让它构建机制“确保应用长期无崩溃”;
    • 重构工作流:在制作季度业务汇报时,不要只让它填模版,而是喂给它全局原始数据,让它推导出最紧迫的 3 个关键决策,甚至设计一套能取代低效周会的实时监控方案。

    2. 挖掘“深度”(Depth):像顶尖行业专家一样死磕

    不满足于表面应付,把模型推到底层工具和方法论的极限:

    • 坚持使用顶级工具:不要满足于让 AI 输出简陋的表格,逼迫它使用真正的数据科学库、数据库与统计模型;
    • 设定“不讲道理”的高目标:告诉模型一个看似严苛的指标(比如将耗时压缩 90%),并坚定告诉它“这完全可行,请继续探索”;
    • 对抗性验证与外部评判:给 AI 原始数据,让它反向推翻团队原本的业务假设;同时引入外部执行工具或测试集来检验输出,而不是让模型自己给自己打分。

    3. 拓展“广度”(Range):打破单兵思维,调动跨界视角

    AI 极大地降低了调用跨学科经验的边际成本:

    • 用“动词”替换“名词”:例如季度报告不仅是“一份 PPT”,本质是“在 30 分钟内让决策层在不确定中达成共识”。有了行为导向,就更容易引入心理学、传播学甚至侦探视角的逻辑;
    • 组建跨角色智囊团:在复杂方案评估中,引入做空机构、法务审计、调查记者等不同维度的分析逻辑来审视方案盲区,但要让模型“执行对应专业的实际调研方法”,而非单纯的角色扮演。

    ---

    核心启发

    心理学上有个概念叫“自我效能感”(Self-efficacy)——人类往往习惯自我设限,只敢在熟悉的舒适区里设定目标。但在 AI 模型能力每隔几周就跃升一次的时代,最先拉开差距的,往往是谁更敢于提出那些看似“过分”的问题与目标。

    原文链接:https://felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models/

    #人工智能 #Claude #提示词工程 #认知升级 #工作流 How to be more ambitious: A tutorial for humans with models
  2. 告别大段文字墙:让 AI Agent 用优雅的 HTML 单页回答复杂问题用 AI 探讨复杂架构、网络协议或技术方案时,我们常常陷入两难:直接输出容易变成难以阅读的“文字墙”,让它手写 HTML 又会因为计算 SVG 坐标和 CSS 样式导致生成极慢、极耗 Token

    告别大段文字墙:让 AI Agent 用优雅的 HTML 单页回答复杂问题

    用 AI 探讨复杂架构、网络协议或技术方案时,我们常常陷入两难:直接输出容易变成难以阅读的“文字墙”,让它手写 HTML 又会因为计算 SVG 坐标和 CSS 样式导致生成极慢、极耗 Token。

    开源项目 Answer me with HTML 为此提供了一个聪明的解法。

    核心亮点

    • Token 暴降 8 倍,生成速度提升 2.6 倍:将“内容表达”与“样式渲染”彻底解耦。大模型只需专注输出简短的 Markdown 草稿,繁重的网格布局、主题配色、SVG 路径绘制全部交由内置 CLI 自动完成。
    • 开箱即用的专业可视化:支持时序图(sequence)、流程图(flow)、状态机、版本时间线、代码高亮引用及特性对比表,复杂逻辑一目了然。
    • 单文件离线可用:产出的单页 HTML 无需任何外部 CDN 或字体依赖,随时双击离线打开,支持亮/暗主题快速切换。
    • 还能生成讲解视频:支持通过 am video 命令将内容转化为 3Blue1Brown 风格的动态演示与语音解说页面,支持导出 MP4/WebM。
    • 全平台 Agent 兼容:原生支持 Claude Code、Cursor、Codex、OpenCode 以及 DeepSeek Harness 等 70+ 款主流 Agent 工具,一键即可安装。

    如果你厌倦了在终端和聊天框里啃长篇大论,不妨试试让 Agent 把答案整理成一张清晰耐读的信息单页。

    项目地址:https://github.com/QingYunA/answer-me-with-html

    #开源项目 #AIAgent #开发者工具 #Claude #前端开发 GitHub - QingYunA/answer-me-with-html: Answer me with HTML — an agent skill that answers hard questions with a one-page HTML you…

  3. 告别反爬攻防:Personal Agent Protocol 试图规范 AI 智能体与企业的连接如今越来越多人开始借助个人 AI Agent(智能体)处理日常琐事,但现状往往面临两难:要么企业将智能体视为爬虫直接拦截,要么智能体接管用户账号进行高风险的“全权模拟操作”,双方陷入无休止的防爬与伪装博弈

    告别反爬攻防:Personal Agent Protocol 试图规范 AI 智能体与企业的连接

    如今越来越多人开始借助个人 AI Agent(智能体)处理日常琐事,但现状往往面临两难:要么企业将智能体视为爬虫直接拦截,要么智能体接管用户账号进行高风险的“全权模拟操作”,双方陷入无休止的防爬与伪装博弈。

    为了打破这种非黑即白的僵局,Personal Agent Protocol(简称 Poppy) 提出了一个全新的开放协议标准,让企业与各类个人智能体能够安全、合规地协作。

    💡 核心特性:

    • 细粒度权限控制:告别“要么完全封禁,要么全权放开”,支持按场景梯次授权(例如:公开搜索无需登录、查看订单需登录、扣款结算需二次确认)。
    • 标准化的服务发现与认证:企业只需在站点配置 /.well-known/poppy.json,Agent 即可自动识别支持的接口;认证采用标准 OAuth,用户直接在官方页面授权,无需向 Agent 共享密码凭据。
    • 多通道统一交互:不仅支持传统 API 和 MCP,还兼顾网页浏览与智能体间会话(Agent-to-Agent),单次签名会话即可串联完整任务流。

    当个人智能体从“暗中爬取”转为“持证上岗”,用户能更安全地自动化繁琐事务,企业也能拥有清晰的访问控制与审计能力。

    https://personalagentprotocol.org/

    #AI智能体 #开放协议 #人工智能 #自动化 Personal Agent Protocol

  4. 做个出色的 Emoji 搜索,真不需要杀鸡用牛刀最近业内热议 Linear 将新型分类推理模型 Jev 引入 Emoji 选择器,体验提升显著

    做个出色的 Emoji 搜索,真不需要杀鸡用牛刀

    最近业内热议 Linear 将新型分类推理模型 Jev 引入 Emoji 选择器,体验提升显著。但开发者 Max Leiter 指出:别把所有分类与检索任务都当成需要大模型推理的“钉子”。

    在针对 4,668 个 Emoji(包含 Unicode 与社区自定义表情)的实测基准测试中:

    • 成本与延迟差距巨大:Jev 每次检索需将整个候选池灌入上下文(单次耗费近 6 万 tokens),成本比 Embedding 高出 1,000 到 10,000 倍,延迟约为 2 倍,且存在服务不稳定的风险;其检索效果虽有微弱提升,但并不具压倒性优势。
    • 纯向量检索更高效:利用 text-embedding-3-large 搭配 pgvector,或直接在浏览器端运行约 35 MB 的小模型(bge-small-en-v1.5)配合二进制向量(Binary Embeddings),就能实现低成本甚至零成本、毫秒级响应的语义检索。
    • 选型建议:
    • 已知集合匹配(如 Emoji、文档检索):优先使用 Embedding 向量检索。
    • 已知标签分类:使用小型分类器或微调模型,成本更低、速度更快。
    • 何时使用 Jev 等推理模型:仅在结果依赖复杂上下文理解、需要逻辑推理而无法单纯依靠向量空间距离解决时,才值得投入高昂成本。

    原文链接:https://maxleiter.com/blog/embedding-emoji-search

    #人工智能 #向量检索 #架构设计 #工程实践 You don't need Jev for good emoji search | Max Leiter

  5. Earendil 的 Pi 终于拥抱了 MCP:一次"真香"背后的思考Earendil 团队曾在官网和播客中多次公开表态"不支持 MCP",但最新版本的 Pi 却将 MCP 纳入了核心功能

    Earendil 的 Pi 终于拥抱了 MCP:一次"真香"背后的思考

    Earendil 团队曾在官网和播客中多次公开表态"不支持 MCP",但最新版本的 Pi 却将 MCP 纳入了核心功能。这不是打脸,而是一次深思熟虑的转变。

    为什么改变了?

    团队给出了三个理由:

    1. MCP 本身在进化。 过去一年,MCP 协议有了显著改进,今天的 MCP 已非昔日可比。
    2. 技术上的协同效应。 将 MCP 引入核心所需的架构改造(如沙箱解释器),同样让 Jev 等其他功能在 Pi 中运行得更顺畅——一举多得。
    3. 主动参与比旁观更好。 与其站在场外批评 MCP 生态中的问题,不如亲自下场,推动它在小型 harness 中更好地工作。

    仍然存在的问题

    MCP 最大的痛点依然是可组合性差——许多 MCP 服务端仍为"把工具一股脑塞进上下文"的模式而设计,返回纯文本而非结构化数据。Earendil 认为 MCP 应该更接近 OpenAPI 的思路:工具返回结构化数据,并通过文档和描述实现智能发现。

    Codemode:关键拼图

    Pi 引入了一个名为 Codemode 的机制——一个运行在 harness 侧的 JavaScript 沙箱,让 AI 能够用代码灵活编排和组合工具调用。配置 MCP 后 Codemode 会自动加载。文章展示了一个令人印象深刻的示例:通过 Codemode 同时调用 Linear MCP 和 Jev 模型,自动分析 issue tracker 中 167 个问题的情绪倾向,整个过程不浪费任何上下文窗口。

    这篇文章传递的核心信息是:技术判断应随环境演变而更新,曾经说"不"并不意味着永远说"不"。

    🔗 https://earendil.com/posts/you-said-no-mcp/

    #MCP #Codemode #Pi #Earendil #AI工具链 “You Said No MCP!” | Earendil

  6. "计划模式"已死:一位开发者从失败产品中学到的教训今年早些时候,Ayman Nadeem 坚信计划(Planning)将成为 AI 编程中最重要的环节,并据此打造了一款桌面编码应用 Nuanced

    "计划模式"已死:一位开发者从失败产品中学到的教训

    今年早些时候,Ayman Nadeem 坚信计划(Planning)将成为 AI 编程中最重要的环节,并据此打造了一款桌面编码应用 Nuanced。其核心理念是:AI 生成代码的速度远超人类理解的速度,开发者需要一个"计划优先"的工作流——先在持久化的规格文档中厘清意图,再交给 Agent 实现。

    然而,这个产品失败了。她总结了四个关键原因:

    1. 混淆了"计划过程"和"计划文档"
    用户需要的是思考的空间,而不是一份冗长的规格说明书。早期用户对生成的 Spec 兴趣寥寥。

    2. 模型能力飞速提升
    随着模型越来越擅长理解代码库并自主做出合理决策,需要人类显式指导的地方越来越少。模型的进步直接削弱了精细计划的必要性。

    3. AI 生成的长文本令人痛苦
    规格文档虽然信息量大,但因为是 AI 生成的——节奏呆板、结构过度——读起来让人眼神涣散。为此又做了"Spec Tour"来引导阅读,结果只是增加了更多复杂性。

    4. 割裂了本应连续的过程
    "聊天→提问→生成规格→审查→批准→实现→审查代码"的线性流程违反了真实的思维方式。现实中,计划和构建是交织进行的,强迫用户"想完再做"反而制造了障碍。

    她观察到,当前 AI 编码工具的趋势正在从线性的 计划→批准→执行 转向迭代的 理解→行动→检查→澄清→调整→再行动。计划并没有消失,只是不再需要以"一份叫计划的文档"的形式存在。

    最终的反思是:帮助人类理解复杂系统这个问题依然没有被解决,尤其当并行 Agent 数量从几个增长到数百个时。Agent 需要学会识别最关键的决策点,把人类的注意力引导到最有价值的地方。

    🔗 https://www.aymannadeem.com/artificial/intelligence,/developer/tools/2026/09/24/plan-mode-is-dead.html

    #AI编程 #开发者工具 #Agent工作流 #人机协作 Plan mode is dead

  7. 告别慢速与幻觉:TypeSafe 发布首个面向代码自动化的 System One 模型 Jev大模型在聊天对话上早已超越常人,但为何在工业级自动化和业务代码中仍然难以落地?前 OpenAI 研究员、ChatGPT 早期核心开发者 Diogo Almeida 创立的 TypeSafe AI 给出了他们的答案:System One Models

    告别慢速与幻觉:TypeSafe 发布首个面向代码自动化的 System One 模型 Jev

    大模型在聊天对话上早已超越常人,但为何在工业级自动化和业务代码中仍然难以落地?前 OpenAI 研究员、ChatGPT 早期核心开发者 Diogo Almeida 创立的 TypeSafe AI 给出了他们的答案:System One Models。

    传统 LLM 本质上是逐字生成的“文本聊天器”,延迟高(数秒至数百秒)、容易幻觉、类型不安全,很难直接作为代码中的逻辑节点使用。TypeSafe 推出的首个模型 Jev 则换了一条路线——放弃自由文本生成,专注做机器原生的结构化决策。

    核心亮点

    • 告别幻觉与类型错误:输出预先定义且类型安全,从数学机制上杜绝类型错误,完美匹配代码下游接口。
    • 极致速度:放弃逐 Token 自回归生成,采用硬件友好的并行采样,端到端延迟仅需 70ms~500ms,速度提升 40~200 倍。
    • 超低成本:输入价格低至 $0.042 / MTok(比主流前沿模型低数个数量级),输出 Token 更是直接免费。
    • 精确校准的置信度:基于新提出的 RLCD(校准决策强化学习)训练,每项决策均附带真实的概率分布,不再“过度自信”。
    • 适用场景:AI 工作流路由(替代脆弱的规则与 if 语句)、实时低延迟交互、海量数据清洗/分类,以及充当其他大模型的 Guardrail 校验器。

    如果说主流大模型像慢速深思的“系统 2(System 2)”,那么 Jev 就是追求极致直觉响应、专门嵌入软件栈的“系统 1(System 1)”函数。

    目前 Jev 已开启早期测试申请。

    原链接:https://typesafe.ai/blog/introducing-system-one-models-and-jev

    #人工智能 #大语言模型 #自动化架构 #开发者工具 Introducing System One Models & Jev - TypeSafe AI Blog

  8. 不止是酷炫动效:设计工程中那些“看不见”的细节在社交媒体上,提到“设计工程师”(Design Engineer),大家往往会联想到那些惊艳丝滑的动效和充满创意的视觉组件

    不止是酷炫动效:设计工程中那些“看不见”的细节

    在社交媒体上,提到“设计工程师”(Design Engineer),大家往往会联想到那些惊艳丝滑的动效和充满创意的视觉组件。视觉效果直观、容易传播,但这也让不少人对这个岗位的认知产生了偏差。

    一个优秀界面的背后,真正决定体验上限的,往往是那些看不见的工作:

    • 性能与响应度:将操作反馈从几百毫秒甚至几秒压缩到极致,让界面感知不到延迟。
    • 无障碍与包容性:支持减弱动态效果(Reduced motion)、优化键盘焦点指示、合理扩大点击热区(Hit areas),确保所有人都能舒适使用。
    • 极端场景与细节打磨:列表项悬停时的微小间隙防误触、可变字体的渲染平滑度、OKLCH 色彩空间的适配,以及多语言环境下的排版与格式自适应。

    在早期初创公司,你可能要打通从设计到落地的整条链路;在成熟团队,你可能深耕在更细分的体验模块。但核心逻辑从未改变:产品是做给人用的,解决的是真实世界的问题。

    做出一套惊艳的动效固然很酷,但花上一下午去死磕一个极少数人才能感知到的可访问性 Bug,或是为了提升一点点首屏加载速度而反复优化,同样是设计工程不可或缺的基石。

    真正顶级的用户体验,往往就藏在这些看不见的地方。

    原文阅读:https://jakub.kr/writing/the-invisible-side-of-design-engineering

    #设计工程 #用户体验 #前端开发 #交互设计 The invisible side of design engineering

  9. AI 时代给年轻开发者的六条建议:写代码已经不够了有人问资深工程师 Matthias Endler,今天会给年轻开发者什么建议

    AI 时代给年轻开发者的六条建议:写代码已经不够了

    有人问资深工程师 Matthias Endler,今天会给年轻开发者什么建议。他的回答出人意料——几乎与代码无关。

    学会做产品。 即使 LLM 能写大部分代码,市场仍然需要能理解用户需求、设计方案、根据反馈迭代的人。这项能力不随技术更替而贬值。

    学会学习。 当信息唾手可得,真正稀缺的是批判性思维和基于数据做决策的能力。理解底层原理,远胜于死记硬背和简单的模式匹配。

    学会沟通。 能把想法讲清楚、能激发他人协作的人,影响力是成倍放大的。别做独狼。

    成为问题解决者。 当所有人都用同样的工具时,拉开差距的是你解决问题的速度和质量。选一个问题,深入领域,建立快速反馈循环,不断迭代。

    拥有不止一项技能。 只会写代码的人很容易被替代。把编程能力和你真正感兴趣的领域结合起来——比如健身、金融、教育——这会大幅缩小你的竞争圈。好奇心驱动的探索比纯靠意志力更持久。

    本质上什么都没变。 上一代人或许仅凭编码能力就能找到工作,但最优秀的开发者从来都不只是写代码。工具变强了,意味着"写代码"本身不再是护城河,你必须锻炼其他肌肉。

    🔗 https://endler.dev/2026/advice-to-young-developers/

    #开发者成长 #AI时代 #职业建议 #软技能 #产品思维 Advice to Young Developers

  10. 算力战国策:拆解主流 AI 芯片的技术哲学与架构之争在摩尔定律与登纳德缩放定律放缓后,AI 算力迎来爆发

    算力战国策:拆解主流 AI 芯片的技术哲学与架构之争

    在摩尔定律与登纳德缩放定律放缓后,AI 算力迎来爆发。大模型计算本质上是海量的矩阵乘法(GEMM / GEMV),而决定性能天花板的从来不是单纯的峰值算力,而是数据移动速度——即如何攻破“内存墙”(Memory Wall)。

    各大芯片巨头对此给出了截然不同的答卷,形成了当下六大主流 AI 芯片路线:

    ---

    1. NVIDIA GPU:极致通用与生态壁垒

    • 核心哲学:高度并行的通用处理器。通过 CUDA 保留统一的编程模型,将硬件复杂度包装在 SM 与 Tensor Core 背后。
    • 架构亮点:通过硬件管理缓存与海量线程(Warp)隐藏访存延迟;从 Blackwell 到 Rubin,引入 TMEM、异步 TMA 与微缩精度(FP4/NVFP4)。
    • 扩展体系:NVLink + NVSwitch 构建低延迟共享内存域;机架级(如 NVL72 / NVL576)坚持采用无源铜缆背板,以极低功耗实现高达 130 TB/s 的全对全互联。
    • 护城河:二十年积累的 CUDA 开发者生态与深度优化的算子库(FlashAttention、CUTLASS 等)。

    2. Google TPU:脉动阵列与编译器至上

    • 核心哲学:专为矩阵乘法而生的专用机器。剔除硬件调度器、分支预测和缓存,把每一拍的调度完全交给 XLA 编译器。
    • 架构亮点:权重常驻(Weight-Stationary)的 MXU 脉动阵列,搭配纯软件管理的暂存内存(VMEM/CMEM);引入 SparseCore 处理非规则的 Embedding 与推荐负载。
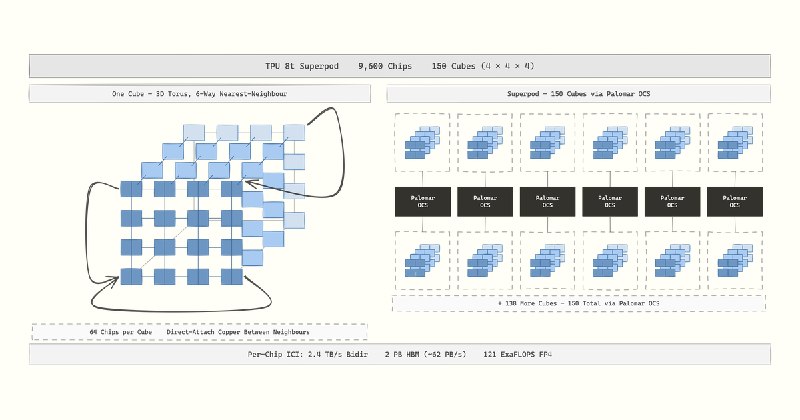
    • 扩展体系:以 3D-Torus(环面拓扑)为核心,配合独创的 Palomar OCS(3D-MEMS 光电路交换机),实现无需停机的动态拓扑重构与近万卡级(Ironwood / TPU v8)超大规模 Scale-up Pod。

    3. AMD Instinct:先进封装与开源联盟

    • 核心哲学:CU 核心架构保持稳健,把算力红利押注在 3D 堆叠封装(TSMC SoIC)与更大容量的 HBM 上。
    • 架构亮点:首创 3D 堆叠 GPU 与 CPU+GPU 统一内存架构(MI300A);配备 256MB 超大 Infinity Cache 缓解访存压力。
    • 扩展体系:推进开放互联标准 UALink 与以太网 RDMA 标准(UEC/UET),在 Helios 机架上正面迎击 NVL72。
    • 软件生态:以 ROCm、HIP、Triton 和 vLLM 为抓手,依托开源社区追赶 CUDA 性能。

    4. Cerebras WSE:不切晶圆的极速怪兽

    • 核心哲学:内存墙源于把晶圆切成小芯片。Cerebras 直接把整块 300mm 晶圆做成单颗芯片(46,225 mm²)。
    • 架构亮点:片上拥有 90 万个数据流核心和 44GB 超高速 SRAM,内部聚合带宽高达 21 PB/s,无 HBM 瓶颈。
    • 应用场景:极限追求单 Token 的生成延迟(Decode 速度远超 GPU 数倍),但受限于 SRAM 成本与容量,更适合作为极致低延迟的专用推理节点。

    5. AWS Trainium:云端全栈性价比

    • 核心哲学:芯片是云服务的组件,只需在 AWS 内部体系内战胜采购 NVIDIA 的成本。
    • 架构亮点:借鉴 TPU 的脉动阵列与 OpenXLA 体系,同时在硬件层面原生集成 CC-Core(集合通信核心),让通信与计算在硅片上真正完全并发。
    • 扩展体系:自研 NeuronSwitch 扁平互联 + Nitro EFA/SRD 弹性以太网,支撑了 Anthropic 百万卡级别的超大规模集群。

    6. Groq LPU:消除一切不确定性的纯静态架构

    • 核心哲学:移除所有硬件仲裁器、缓存与动态调度,打造完全确定性(Deterministic)的处理器,执行时间在编译期精确到周期。
    • 架构亮点:片上全 SRAM 空间流式处理,数据如流水线般穿过功能切片;多卡之间无需交换机,纯静态编译路由。
    • 最终归宿:单卡容量极小、扩展成本高,其低延迟推理技术最终被英伟达吸收,作为超低延迟推理协处理器协同工作。

    ---

    💡 核心趋势与行业共识

    1. 单芯片算力趋同,系统工程定胜负:各家旗舰的单芯片 FP8/FP4 峰值已十分接近,竞争焦点彻底转向机架级互联(Scale-up 域大小)、光电混合交换与液冷系统工程。
    2. 两极化的内存博弈:一条路是以 HBM 为代表的大容量路线(满足长上下文与大批次吞吐);另一条路是以纯 SRAM 为代表的高带宽路线(追求单用户极致低延迟)。
    3. 软件范式收敛:从早期的手写专用底层算子,正逐步向 Triton、MLIR、XLA 等现代编译中间层收敛,软硬件解耦正在打破单一供应商的生态锁定。

    🔗 原文链接:https://www.jacobpeake.com/ai-chip-architectures

    #AI芯片 #半导体架构 #NVIDIA #TPU #大模型算力 AI Chip Architectures

  11. 代码不再是瓶颈:Anthropic 发布的「AI 原生软件工程(SDLC)实战手册」随着 Claude Code 等 Agent 编码工具的普及,编写代码的时间被大幅压缩至数小时

    代码不再是瓶颈:Anthropic 发布的「AI 原生软件工程(SDLC)实战手册」

    随着 Claude Code 等 Agent 编码工具的普及,编写代码的时间被大幅压缩至数小时。然而,传统的软件开发生命周期(SDLC)仍按“人类速度”运行——繁复的需求对齐、人工逐行 Code Review 和层层审批,反而成为了团队新的生产力瓶颈。

    Anthropic 官方近期梳理了一套完整的 AI-Native SDLC 转型框架,将传统的线性研发流程重构为以 Markdown 产物驱动的自治闭环:

    ---

    🔄 六大阶段的关键演进

    1. 规划(Plan)|意图即代码
    • 告别漫长繁琐的 PRD 编写,业务人员通过与 Claude 头脑风暴直接生成 intent.md(意图文件)。
    • 机器可读、人类可审,提交至 Git 即可直接驱动下一阶段。

    2. 设计(Design)|需求与设计合二为一
    • 结合团队沉淀的规范库(Skills),Claude 基于 intent.md 快速产出 spec.md。
    • 安全、合规与 UX 约束在生成设计时即刻生效,而非等到几周后的评审会议才被发现。

    3. 构建(Build)|计划驱动与组织记忆
    • Plan Mode:必须先生成并确认 plan.md 才能落代码,杜绝 Agent 盲目编码。
    • 团队记忆库:通过 CLAUDE.md 和 Skills 固化团队规约;借助 Hooks 建立不可逾越的确定性防线。
    • 并行作战:配合 Git Worktree 和专有子 Agent(Subagents),单名工程师可同时调度多个任务。

    4. 测试(Test)|让 AI 自查自纠
    • 反馈闭环:为 Agent 配备自动化测试与 UI 视觉对比工具,要求“跑通测试才算 Done”,并禁止 AI 擅自修改测试用例以掩盖 Bug。
    • Continuous Evals:在 CI 中引入 Agent 评估套件,像测代码一样回归测试提示词与配置。

    5. 部署(Deploy)|双向审查与严格卡点
    • AI 参与 PR 自动化多维度评审,并支持直接根据 @claude 评论修复代码;人类工程师重点聚焦于“业务意图”与“系统风险”。
    • 生产门禁:AI 的自主权终止于生产部署关卡,核心发布动作仍由 Hooks 拦截并等待人工最终授权。

    6. 运维(Maintain)|自主闭环的起点
    • 当监控指标(如 CI 失败率、5xx 错误)出现统计学异常时,自动化脚本唤醒 Claude 进行故障诊断并生成修复 PR 或新的 intent.md。
    • 结合即时通讯工具(Claude Tag),实现告警自动排查、知识沉淀与自主闭环。

    ---

    核心总结:AI 原生 SDLC 的本质,是把研发流程从“人写代码、人走流程”,升级为“AI 负责闭环执行、人类把控关键治理与评判”的全新协作范式。

    🔗 原文链接:https://claude.com/blog/the-ai-native-sdlc-playbook

    #AI开发 #SDLC #ClaudeCode #软件工程 #人工智能 The AI-native SDLC playbook

  12. 腾讯微信开源通用多模态向量模型 WeMM-Embedding:刷新 MMEB-v2 榜单,已在微信多业务落地腾讯微信视觉团队近日开源了通用多模态嵌入模型家族 WeMM-Embedding,论文与模型权重现已全面公开

    腾讯微信开源通用多模态向量模型 WeMM-Embedding:刷新 MMEB-v2 榜单,已在微信多业务落地

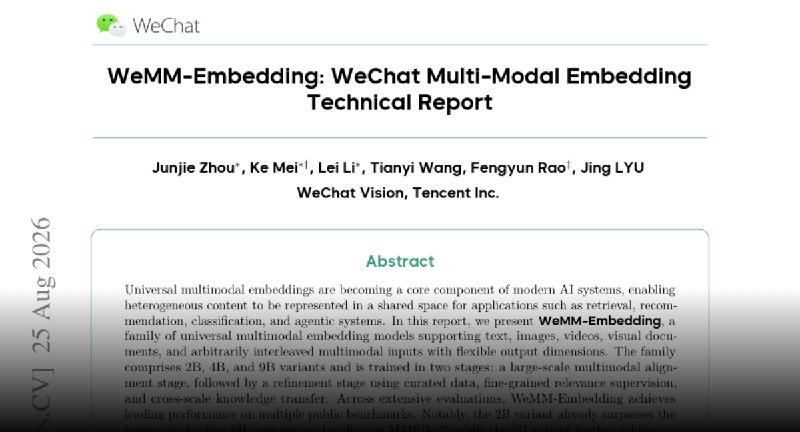
    腾讯微信视觉团队近日开源了通用多模态嵌入模型家族 WeMM-Embedding,论文与模型权重现已全面公开。

    🌟 核心亮点

    • 全模态统一表征:支持文本、图片、视频、视觉文档以及任意图文交错(Interleaved)混合输入,并支持灵活调整输出向量维度。
    • 2B/4B/9B 多尺寸覆盖:
    • 2B 规格:表现强劲,性能已超越此前 8B 级别的开源 Baseline。
    • 9B 规格:在多模态检索与表征权威评测榜单 MMEB-v2 上取得 80.6 分,刷新综合 SOTA 纪录。
    • 两阶段训练架构:先通过大规模多模态数据完成空间对齐,再利用高质量精选数据、细粒度相关性监督与跨尺度知识迁移进行优化。
    • 工业级实战验证:不仅在微信内部 26 项基准测试和 14 组线上 A/B 测试中表现优异,目前已在视频号、微信公众号、朋友圈及电商搜索/推荐等核心场景规模化上线。

    ---

    🔗 相关链接:

    • 论文页面:https://huggingface.co/papers/2608.24053
    • 模型集合:https://huggingface.co/collections/tencent/wemm-embedding
    • GitHub 开源地址:https://github.com/Tencent/WeMM-Embedding

    #多模态 #Embedding #腾讯 #开源模型 #微信团队 Paper page - WeMM-Embedding: WeChat Multi-Modal Embedding Technical Report

  13. 从“生成报告”到“解决复杂任务”:Apodex 1.1 正式发布传统的 AI 深度搜索往往以生成一份结构化报告为终点,但科研、金融和法律等领域的真实工作,通常在写完报告后才刚开始——清洗脏数据、选择方法、编写运行代码、根据中间结果调整方案,并保证每项结论都能经得起溯源检验

    从“生成报告”到“解决复杂任务”:Apodex 1.1 正式发布

    传统的 AI 深度搜索往往以生成一份结构化报告为终点,但科研、金融和法律等领域的真实工作,通常在写完报告后才刚开始——清洗脏数据、选择方法、编写运行代码、根据中间结果调整方案,并保证每项结论都能经得起溯源检验。

    针对这一痛点,Apodex 正式推出了 Apodex 1.1,旨在将 AI 从单纯的“问答工具”升级为能够处理长周期、多阶段复杂任务的在线工作台。

    ---

    核心亮点一览

    1. 真实环境下的长链路执行

    不再回避复杂的专业格式(CSV、PDF、分子结构等)。模型在真实的文件与代码环境中运行,自主处理异常并完成端到端的数据分析与交付。

    2. 支持运行中随时介入(Human-in-the-loop)

    复杂任务难免需要中途调整。Apodex 1.1 允许用户在任务执行的任意阶段添加新需求或新数据,系统会自动保留有效的中间产物并重新规划后续路径,无需从头再来。

    3. 任务分解与执行状态全透明

    拒绝黑盒等待。基于底层 AgentOS,系统会实时展示当前的执行计划、完成步骤、生成的产物与异常重试情况,让长耗时任务清晰可控。

    4. 自主异步多智能体团队(Agent Team)

    在 Deep Discover 模式下,模型会自主将复杂任务拆解并分发给多个子智能体并行探索。中间结果实时回流至主任务,大幅缩短复杂探索的等待耗时。

    5. 关键结论独立审查(Statement Review)

    将“内容生成”与“结论审核”解耦。针对数据推论、文献引用和计算结果进行独立的交叉校验与证据链追溯,显著降低幻觉风险。

    6. 开源支持与端侧部署

    除了网页端完整版,团队还推出了可本地部署的 35B Apodex 1.1 Mini,并开源了开箱即用的终端智能体框架 FrontierAgent(支持 macOS / Linux 单命令运行)。

    ---

    🔗 原文链接:https://www.apodex.com/blog/apodex-1.1-scaling-agentic-intelligence-for-complex-work

    #人工智能 #AI智能体 #Apodex #大语言模型 #深度研究 Apodex 1.1: Scaling Agentic Intelligence for Complex Work - Apodex | AI for Discovery

  14. AI Agent 框架如何实现崩溃自愈?深入 Pi 的 Durable Harness v2 架构设计在构建复杂且长周期的 AI Agent 系统时,进程崩溃、外部 API 超时以及并发冲突是不可避免的挑战

    AI Agent 框架如何实现崩溃自愈?深入 Pi 的 Durable Harness v2 架构设计

    在构建复杂且长周期的 AI Agent 系统时,进程崩溃、外部 API 超时以及并发冲突是不可避免的挑战。开源 AI Agent 工具库 Pi(earendil-works/pi)发布了其核心执行引擎 AgentHarness v2 的设计规范,全面重构了 Agent 的持久化、并发与容错模型。

    ---

    核心设计亮点

    1. 确定性持久化与崩溃恢复(Durable Runs)
    • 预写意图(Intent-first):在执行任何副作用(LLM 请求、工具调用)之前,必须先持久化一条意图记录;执行完成后再将结果作为节点提交。
    • 零中间态:无论是调用中断、系统崩溃还是上下文超限,重启后都能根据日志精确定位到最近的安全边界进行恢复或重试,绝不产生不一致的脏状态。

    2. Lanes(多泳道并行架构)
    • 引入类似 Git 分支的 Lane 概念。一个会话(Session)拥有唯一的共享对话树,但可以在上面并发运行多个独立的 Lane(如 Slack 频道下的不同 Thread)。
    • 每个 Lane 拥有独立的 Leaf 指针与操作日志,保证多任务互不干扰且免受竞态冲突影响。

    3. 对 KV Cache 极度友好的追加模式(Append-Only Context)
    • 运行中所有交互和配置修改均以追加(Append)形式进入上下文,避免因中间插入导致模型端 KV Cache 失效,显著降低 Token 消耗与延迟。
    • 只有在显式触发压缩(Compaction)时才做重整。

    4. 单步驱动与确定性测试(Deterministic Stepping)
    • 支持 manual 驱动模式:Agent 的每一个网络请求、工具执行、Hook 回调和存储写入都会在虚拟门控前暂停。
    • 开发者和测试套件可以一步步单步调试,任意注入输入或模拟崩溃,彻底消除异步 Agent 系统的难以复现的隐蔽 Bug。

    5. 清晰的职责分离
    • Session Tree:只负责只增的对话与事实树,不掺杂编排逻辑。
    • Operation Logs:记录状态机流水,专为崩溃恢复服务。
    • Hooks 与 Events 分立:Hooks 负责拦截与修改执行流,Events 负责单向、实时的 UI 状态订阅。
    • 多存储后端:原生适配内存、JSONL 与 SQLite,并向下兼容 v3 格式。

    ---

    对于正在探索长时间运行 Agent、多分支 Agent 或企业级容错工作流的开发者来说,Pi 的 Harness v2 提供了一套非常严谨、工业级的状态机与架构参考范式。

    完整设计文档:https://github.com/earendil-works/pi/blob/harness-v2/j4/packages/agent/docs/harness-v2.md

    #AIAgent #系统架构 #开源项目 #LLM #状态机 pi/packages/agent/docs/harness-v2.md at harness-v2/j4 · earendil-works/pi

  15. 别再死磕终端界面了:AI 时代,我们该重新拥抱原生 GUI长久以来,开发者群体对终端(CLI)与终端图形界面(TUI)有着近乎执念的情怀

    别再死磕终端界面了:AI 时代,我们该重新拥抱原生 GUI

    长久以来,开发者群体对终端(CLI)与终端图形界面(TUI)有着近乎执念的情怀。我们习惯了用 ASCII 字符画窗口,忍受终端里生硬的滚动、选词和无障碍支持。但资深安全研究员与开发者 Thomas Ptacek 近日撰文直言:是时候停止编写新的 TUI,全面转向原生图形界面(Native GUI)了。

    为什么我们曾执着于 TUI?

    作者指出,CLI(命令行接口)具备不可替代的组合能力,永远不会过时;但 TUI(终端用户界面,如借助 Curses、Ratatui 等构建的字符界面)本质上是 70 年代哑终端与调制解调器时代的产物。开发者之所以青睐 TUI,往往不是因为终端天生更优越,而是过去开发原生 GUI 的学习成本和琐碎代码实在令人望而却步。

    在终端里,开发者需要费尽心思去模拟原生控件早已完美实现的基础特性:平滑滚动、拖放交互、多窗口浮动、图片渲染以及无障碍(a11y)支持。

    AI 彻底打破了原生 GUI 的门槛

    以往编写 SwiftUI、GTK 或 WinUI 需要掌握大量繁重的平台细节,但现在通过 Claude、Codex 等 AI Agent,构建原生界面的难度被降到了极低:

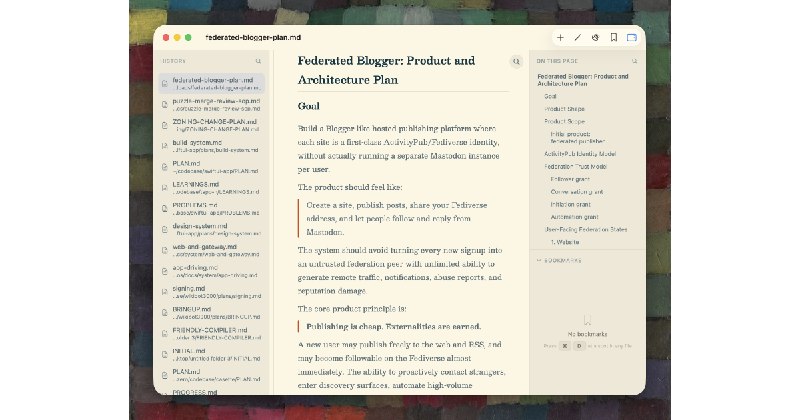
    • 作者在几乎没有手写 UI 代码的情况下,快速“召唤”出了一批自用原生 Mac 工具:Markdown 渲染器、SageMath 公式计算器、基于 SQLite 的 AI 音乐播放器、状态栏遥控器等。
    • 原生框架天生具备一致的设计语言、流畅的交互与完善的语义无障碍树,开发体验与最终成品质量远胜在终端中“打补丁”。

    驳斥几个常见的 TUI 迷思

    1. “TUI 信息密度高、键盘流效率高”:GUI 同样可以做到极高密度和纯键盘操作(如彭博终端),只是以往少有人专门为 Geek 定制。
    2. “TUI 方便 SSH 远程管理”:生产环境真正需要的是健壮的 CLI,完全可以由本地原生客户端(类似 Emacs TRAMP 的模式)来驱动远程交互。
    3. “TUI 更轻量、跨平台”:如果是为了自己顺手打造的小工具,为兼顾跨平台而牺牲全部交互体验并不划算。

    结语
    AI 正在消除前后端与图形界面的开发鸿沟。如果你依然习惯于把自用工具限制在黑黢黢的终端字符里,不妨尝试让 AI 为你的小脚本生成一个原生 GUI——这很可能会彻底改变你与计算机交互的方式。

    https://sockpuppet.org/blog/2026/08/20/stop-making-tuis/

    #软件开发 #原生应用 #SwiftUI #TUI #人工智能 Stop Making TUIs

  16. 你的网站对 AI 智能体友好吗?Vercel 推出评估工具 Is Agentic随着 AI Agent(智能体)逐渐成为网络内容的重要消费者与使用者,网站不仅要为人类设计,也需要对 AI 更加友好

    你的网站对 AI 智能体友好吗?Vercel 推出评估工具 Is Agentic

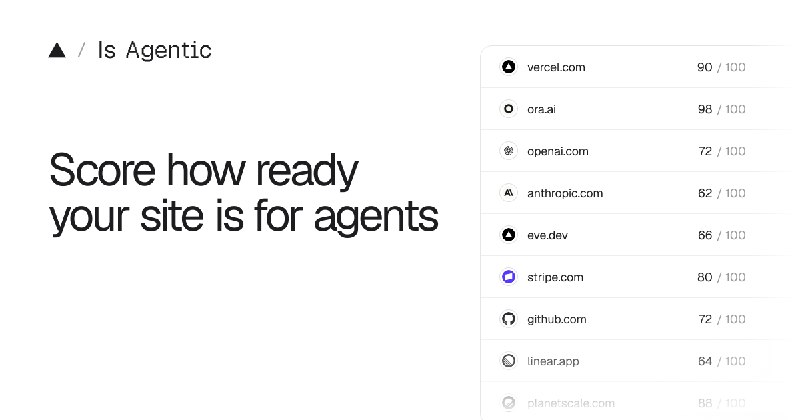
    随着 AI Agent(智能体)逐渐成为网络内容的重要消费者与使用者,网站不仅要为人类设计,也需要对 AI 更加友好。Vercel 联手 Ora 推出了 Is Agentic,一个专门评估网站“Agent 就绪度”(AI Agent Readiness Score)的在线测试工具。

    核心亮点:

    • 多维度能力检测:评估 AI Agent 在网站上的发现、检索、理解与交互体验。主要涵盖服务端渲染(SSR)、清晰的语义化结构、规范的 HTTP 响应及可恢复的错误处理等基础指标。
    • 动态匹配,不滥扣分:根据网站实际能力进行推荐项检测(如 API、OAuth 认证、GraphQL、MCP Server 支持等)。若网站本就不包含特定接口,不会因此扣分。
    • 具象化诊断与路径观察:不仅给出具体改进建议,还会记录 Agent 实际浏览该网站时的操作路径与遇到的阻碍(Friction)。
    • 面向 Agent 优化输出:支持直接以 Markdown、JSON API 形式读取报告,并提供了专属的 MCP(Model Context Protocol)Server,方便将检测能力直接集成到各类 Agent 工作流中。

    输入网址即可快速测试你的网站对 AI 智能体的易用程度,并获取针对性的优化建议。

    访问地址:https://is-agentic.com

    #AIAgent #Web开发 #Vercel #MCP #开发者工具 Is Agentic: AI Agent Readiness Score for your Site and App

  17. 让 AI 也能做出极简可爱的吉祥物:IP as Logo Skill为产品设计一个辨识度高、圆润可爱的 IP Logo 往往需要多次打磨

    让 AI 也能做出极简可爱的吉祥物:IP as Logo Skill

    为产品设计一个辨识度高、圆润可爱的 IP Logo 往往需要多次打磨。开源项目 ip-as-logo-skill 为具备生图能力的 AI Agent 提供了一套结构化的设计规范,帮助你一键生成可以直接商用的极简 IP 角色。

    🌟 核心亮点

    • 严控设计复杂度:遵循极简与微拟物(Neo-skeuomorphism)美学,主体由 4~7 个基础圆形几何构成,默认采用「2 种 IP 主色 + 1 种纯色背景」的三色搭配。
    • 精心调校的构图:角色默认从左下角或右下角探出并占据画面 85%~95%,避免传统居中构图的呆板感。
    • 标准化的生图流程:Agent 会先梳理产品背景并提供 3 种设计方向,确认后一次性生成 6 张不同构图的独立高清候选图,无需繁琐调试提示词。
    • 纯净的 Prompt 策略:提示词专注描述画面视觉元素,不包含 “logo/icon” 等干扰词,充分释放图像模型的生成质感。

    🛠️ 兼容性与安装

    支持 Codex、豆包、Coze、Manus、YouMind、Gemini Apps、Replit Agent 等支持图像资产输出的 Agent 环境。

    通过 Agent Skills CLI 一键安装:

    npx skills@latest add s1dashu/ip-as-logo-skill


    项目采用 MIT 协议开源,生成内容均可免费商用。此外,作者还提供了免费的在线图库 ipaslogo.com,无需配置即可直接下载现成素材。

    🔗 项目地址:https://github.com/s1dashu/ip-as-logo-skill

    #开源项目 #AIAgent #Logo设计 #AI生图 #设计工具

  18. 开源模型实现端到端自我提升:Ornith-1.5 正式发布Ornith 正式推出了 Ornith-1.5 模型家族,将此前的“自我脚手架(Self-Scaffolding)”机制拓展为完整的端到端自我进化闭环

    开源模型实现端到端自我提升:Ornith-1.5 正式发布

    Ornith 正式推出了 Ornith-1.5 模型家族,将此前的“自我脚手架(Self-Scaffolding)”机制拓展为完整的端到端自我进化闭环。模型不再单纯依赖人工标注数据,而是能够自主生成新任务、构建评估脚手架,并通过强化学习(GRPO)持续进行自我迭代与能力突破。

    ---

    核心技术亮点:自我驱动的学习闭环

    在每个训练周期中,Ornith-1.5 协同优化三个关键环节:

    1. 自主出题(Task Generation):根据历史解决记录,生成处于能力边界前沿、有效且具有多样性的新挑战。
    2. 构建脚手架(Scaffold Construction):自主设计解题策略、工具链和评估环境,并加入防作弊与对齐奖励机制。
    3. 策略优化(GRPO RL):通过解答方案的反馈,联合优化出题质量、脚手架有效性与模型解题策略,实现能力螺旋上升。

    ---

    三种规格模型与性能表现

    Ornith-1.5 覆盖了大中小三种参数规格,在代码生成、复杂推理与 Agent 任务上均有亮眼表现:

    • Ornith-1.5-397B(旗舰 MoE):
    在 Terminal-Bench 2.1 取得 86.1 分,DeepSWE 取得 56.0 分,整体性能比肩 Claude Opus 4.8,并全面超越同体量的开源模型(如 DeepSeek-V4-Flash 与 GLM-5.2)。

    • Ornith-1.5-35B(轻量 MoE,单 Token 仅激活 3B):
    在 Agent 编程和代码基准(如 SWE-Bench Verified)上大幅领先同量级对手,甚至显著超越了多款 30B 级别的稠密模型。

    • Ornith-1.5-9B(端侧 Dense):
    专为边缘设备优化,提供手机端量化版本(支持 iPhone 与 Android),在紧凑体积下展现出越级打怪的推理与代码能力。

    ---

    🔗 阅读原文:https://ornith.ai/ornith_1_5.html

    #人工智能 #开源大模型 #强化学习 #AI编程 Ornith-1.5: From Self-Scaffolding to Self-Improvement

  19. 通俗解读:什么是 AI 时代的「Agent Harness」?业界常用一个极简公式来定义智能体:Agent = Model + Harness

    通俗解读:什么是 AI 时代的「Agent Harness」?

    业界常用一个极简公式来定义智能体:Agent = Model + Harness。

    如果把大模型(Model)比作攀登者的核心力量,那么 Harness(原意为登山安全带/挽具) 就是为你提供支撑、挂载工具并确保安全的整套装备。

    在 AI 领域,Agent Harness 是为模型提供运行环境的软件外壳。它主要承担四个核心职能:

    1. 系统提示(System Prompt):像给新员工的工作指引,规范模型在特定场景下的行为准则。
    2. 工具挂载(Tools):为模型提供搜索、写代码、发邮件等能力接口,并由模型自主判断何时调用。
    3. 自主循环(Agentic Loop):构建「理解任务 ➔ 调用工具 ➔ 评估结果 ➔ 自主修正 ➔ 交付成果」的完整工作流闭环。
    4. 模型转换层(Translation Layer):抹平不同大模型(OpenAI、Anthropic、开源模型等)的接口差异,支持灵活切换与混用。

    为什么 Harness 越来越重要?
    大模型往往掌握在少数巨头手中,但 Harness 可以开源并运行在本地。借助像 Pi、OpenClaw 这类中立的开源框架,用户能够将控制权掌握在自己手中,按需定制属于自己的 AI 工作流。

    阅读原文:https://earendil.com/posts/what-is-a-harness/

    #AI智能体 #Agent #人工智能 #开源技术 What is a Harness? | Earendil

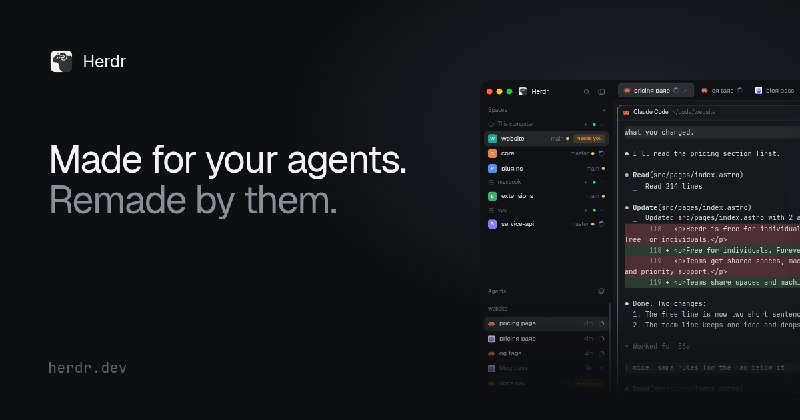
  20. 告别合盖中断:为 AI 编程智能体打造的专属后台运行环境 Herdr在使用 Claude Code、Codex 等 AI 编程助手时,许多人经常遇到两个痛点:一旦合上笔记本电脑或断开连接任务就会中断;同时跑多个 Agent 时,很难及时发现哪一个正在等待输入确认

    告别合盖中断:为 AI 编程智能体打造的专属后台运行环境 Herdr

    在使用 Claude Code、Codex 等 AI 编程助手时,许多人经常遇到两个痛点:一旦合上笔记本电脑或断开连接任务就会中断;同时跑多个 Agent 时,很难及时发现哪一个正在等待输入确认。

    Herdr 正是为解决这些问题而生的智能体运行时(Runtime)。它作为一个后台服务运行,接管终端会话,让你的 AI 智能体可以全天候自主工作。

    核心特性

    • 后台常驻,合盖不掉线:终端直接运行在 Herdr 后台服务中,即使关闭电脑屏幕、网络断开甚至系统重启,会话与分屏布局都能完整保留并继续执行。
    • 状态感知,告别逐屏排查:自动识别每个窗格中 Agent 的实时状态(工作中 / 等待输入 / 空闲),当某个 Agent 需要人工确认时一目了然,无需在多个终端间来回切换。
    • Agent 原生协作:提供统一的 CLI 与 Socket API,不同的 Agent 可以自主分屏、相互唤起并协同处理复杂任务。
    • 开箱即用,无缝兼容:无需改变原有的使用习惯,开箱支持 Claude Code、Cursor、Codex、Copilot 等 20 多种主流 Agent CLI,单二进制文件支持 macOS、Linux 和 Windows。

    安装只需一行命令即可接入现有的开发流,让 AI 智能体真正具备独立持续干活的能力。

    原链接:https://herdr.dev/

    #AI编程 #Agent运行时 #开发者工具 #ClaudeCode #终端工具 Herdr: made for your agents, remade by them

1px