Search: #AI时代

  1. AI 时代给年轻开发者的六条建议:写代码已经不够了有人问资深工程师 Matthias Endler,今天会给年轻开发者什么建议

    AI 时代给年轻开发者的六条建议:写代码已经不够了

    有人问资深工程师 Matthias Endler,今天会给年轻开发者什么建议。他的回答出人意料——几乎与代码无关。

    学会做产品。 即使 LLM 能写大部分代码,市场仍然需要能理解用户需求、设计方案、根据反馈迭代的人。这项能力不随技术更替而贬值。

    学会学习。 当信息唾手可得,真正稀缺的是批判性思维和基于数据做决策的能力。理解底层原理,远胜于死记硬背和简单的模式匹配。

    学会沟通。 能把想法讲清楚、能激发他人协作的人,影响力是成倍放大的。别做独狼。

    成为问题解决者。 当所有人都用同样的工具时,拉开差距的是你解决问题的速度和质量。选一个问题,深入领域,建立快速反馈循环,不断迭代。

    拥有不止一项技能。 只会写代码的人很容易被替代。把编程能力和你真正感兴趣的领域结合起来——比如健身、金融、教育——这会大幅缩小你的竞争圈。好奇心驱动的探索比纯靠意志力更持久。

    本质上什么都没变。 上一代人或许仅凭编码能力就能找到工作,但最优秀的开发者从来都不只是写代码。工具变强了,意味着"写代码"本身不再是护城河,你必须锻炼其他肌肉。

    🔗 https://endler.dev/2026/advice-to-young-developers/

    #开发者成长 #AI时代 #职业建议 #软技能 #产品思维 Advice to Young Developers
  2. 算力战国策:拆解主流 AI 芯片的技术哲学与架构之争在摩尔定律与登纳德缩放定律放缓后,AI 算力迎来爆发

    算力战国策:拆解主流 AI 芯片的技术哲学与架构之争

    在摩尔定律与登纳德缩放定律放缓后,AI 算力迎来爆发。大模型计算本质上是海量的矩阵乘法(GEMM / GEMV),而决定性能天花板的从来不是单纯的峰值算力,而是数据移动速度——即如何攻破“内存墙”(Memory Wall)

    各大芯片巨头对此给出了截然不同的答卷,形成了当下六大主流 AI 芯片路线:

    ---

    1. NVIDIA GPU:极致通用与生态壁垒

    核心哲学:高度并行的通用处理器。通过 CUDA 保留统一的编程模型,将硬件复杂度包装在 SM 与 Tensor Core 背后。
    架构亮点:通过硬件管理缓存与海量线程(Warp)隐藏访存延迟;从 Blackwell 到 Rubin,引入 TMEM、异步 TMA 与微缩精度(FP4/NVFP4)。
    扩展体系:NVLink + NVSwitch 构建低延迟共享内存域;机架级(如 NVL72 / NVL576)坚持采用无源铜缆背板,以极低功耗实现高达 130 TB/s 的全对全互联。
    护城河:二十年积累的 CUDA 开发者生态与深度优化的算子库(FlashAttention、CUTLASS 等)。

    2. Google TPU:脉动阵列与编译器至上

    核心哲学:专为矩阵乘法而生的专用机器。剔除硬件调度器、分支预测和缓存,把每一拍的调度完全交给 XLA 编译器。
    架构亮点:权重常驻(Weight-Stationary)的 MXU 脉动阵列,搭配纯软件管理的暂存内存(VMEM/CMEM);引入 SparseCore 处理非规则的 Embedding 与推荐负载。
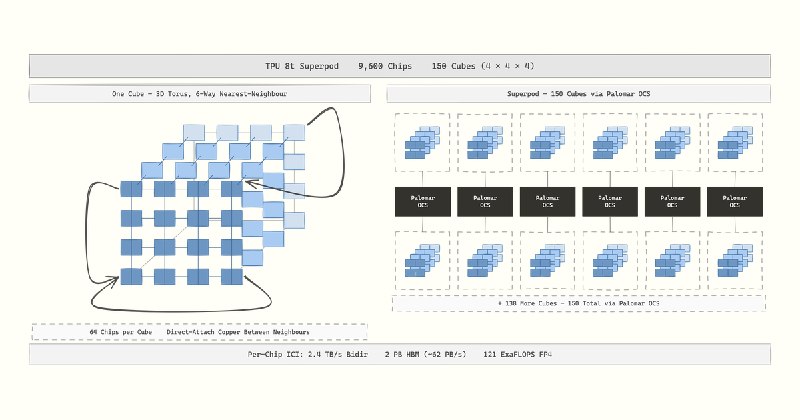
    扩展体系:以 3D-Torus(环面拓扑)为核心,配合独创的 Palomar OCS(3D-MEMS 光电路交换机),实现无需停机的动态拓扑重构与近万卡级(Ironwood / TPU v8)超大规模 Scale-up Pod。

    3. AMD Instinct:先进封装与开源联盟

    核心哲学:CU 核心架构保持稳健,把算力红利押注在 3D 堆叠封装(TSMC SoIC)与更大容量的 HBM 上。
    架构亮点:首创 3D 堆叠 GPU 与 CPU+GPU 统一内存架构(MI300A);配备 256MB 超大 Infinity Cache 缓解访存压力。
    扩展体系:推进开放互联标准 UALink 与以太网 RDMA 标准(UEC/UET),在 Helios 机架上正面迎击 NVL72。
    软件生态:以 ROCm、HIP、Triton 和 vLLM 为抓手,依托开源社区追赶 CUDA 性能。

    4. Cerebras WSE:不切晶圆的极速怪兽

    核心哲学:内存墙源于把晶圆切成小芯片。Cerebras 直接把整块 300mm 晶圆做成单颗芯片(46,225 mm²)。
    架构亮点:片上拥有 90 万个数据流核心和 44GB 超高速 SRAM,内部聚合带宽高达 21 PB/s,无 HBM 瓶颈。
    应用场景:极限追求单 Token 的生成延迟(Decode 速度远超 GPU 数倍),但受限于 SRAM 成本与容量,更适合作为极致低延迟的专用推理节点。

    5. AWS Trainium:云端全栈性价比

    核心哲学:芯片是云服务的组件,只需在 AWS 内部体系内战胜采购 NVIDIA 的成本。
    架构亮点:借鉴 TPU 的脉动阵列与 OpenXLA 体系,同时在硬件层面原生集成 CC-Core(集合通信核心),让通信与计算在硅片上真正完全并发。
    扩展体系:自研 NeuronSwitch 扁平互联 + Nitro EFA/SRD 弹性以太网,支撑了 Anthropic 百万卡级别的超大规模集群。

    6. Groq LPU:消除一切不确定性的纯静态架构

    核心哲学:移除所有硬件仲裁器、缓存与动态调度,打造完全确定性(Deterministic)的处理器,执行时间在编译期精确到周期。
    架构亮点:片上全 SRAM 空间流式处理,数据如流水线般穿过功能切片;多卡之间无需交换机,纯静态编译路由。
    最终归宿:单卡容量极小、扩展成本高,其低延迟推理技术最终被英伟达吸收,作为超低延迟推理协处理器协同工作。

    ---

    💡 核心趋势与行业共识

    1. 单芯片算力趋同,系统工程定胜负:各家旗舰的单芯片 FP8/FP4 峰值已十分接近,竞争焦点彻底转向机架级互联(Scale-up 域大小)、光电混合交换与液冷系统工程。
    2. 两极化的内存博弈:一条路是以 HBM 为代表的大容量路线(满足长上下文与大批次吞吐);另一条路是以纯 SRAM 为代表的高带宽路线(追求单用户极致低延迟)。
    3. 软件范式收敛:从早期的手写专用底层算子,正逐步向 Triton、MLIR、XLA 等现代编译中间层收敛,软硬件解耦正在打破单一供应商的生态锁定。

    🔗 原文链接:https://www.jacobpeake.com/ai-chip-architectures

    #AI芯片 #半导体架构 #NVIDIA #TPU #大模型算力 AI Chip Architectures

  3. 代码不再是瓶颈:Anthropic 发布的「AI 原生软件工程(SDLC)实战手册」随着 Claude Code 等 Agent 编码工具的普及,编写代码的时间被大幅压缩至数小时

    代码不再是瓶颈:Anthropic 发布的「AI 原生软件工程(SDLC)实战手册」

    随着 Claude Code 等 Agent 编码工具的普及,编写代码的时间被大幅压缩至数小时。然而,传统的软件开发生命周期(SDLC)仍按“人类速度”运行——繁复的需求对齐、人工逐行 Code Review 和层层审批,反而成为了团队新的生产力瓶颈。

    Anthropic 官方近期梳理了一套完整的 AI-Native SDLC 转型框架,将传统的线性研发流程重构为以 Markdown 产物驱动的自治闭环

    ---

    🔄 六大阶段的关键演进

    1. 规划(Plan)|意图即代码
    • 告别漫长繁琐的 PRD 编写,业务人员通过与 Claude 头脑风暴直接生成 intent.md(意图文件)。
    • 机器可读、人类可审,提交至 Git 即可直接驱动下一阶段。

    2. 设计(Design)|需求与设计合二为一
    • 结合团队沉淀的规范库(Skills),Claude 基于 intent.md 快速产出 spec.md
    • 安全、合规与 UX 约束在生成设计时即刻生效,而非等到几周后的评审会议才被发现。

    3. 构建(Build)|计划驱动与组织记忆
    Plan Mode:必须先生成并确认 plan.md 才能落代码,杜绝 Agent 盲目编码。
    团队记忆库:通过 CLAUDE.md 和 Skills 固化团队规约;借助 Hooks 建立不可逾越的确定性防线。
    并行作战:配合 Git Worktree 和专有子 Agent(Subagents),单名工程师可同时调度多个任务。

    4. 测试(Test)|让 AI 自查自纠
    反馈闭环:为 Agent 配备自动化测试与 UI 视觉对比工具,要求“跑通测试才算 Done”,并禁止 AI 擅自修改测试用例以掩盖 Bug。
    Continuous Evals:在 CI 中引入 Agent 评估套件,像测代码一样回归测试提示词与配置。

    5. 部署(Deploy)|双向审查与严格卡点
    • AI 参与 PR 自动化多维度评审,并支持直接根据 @claude 评论修复代码;人类工程师重点聚焦于“业务意图”与“系统风险”。
    生产门禁:AI 的自主权终止于生产部署关卡,核心发布动作仍由 Hooks 拦截并等待人工最终授权。

    6. 运维(Maintain)|自主闭环的起点
    • 当监控指标(如 CI 失败率、5xx 错误)出现统计学异常时,自动化脚本唤醒 Claude 进行故障诊断并生成修复 PR 或新的 intent.md
    • 结合即时通讯工具(Claude Tag),实现告警自动排查、知识沉淀与自主闭环。

    ---

    核心总结:AI 原生 SDLC 的本质,是把研发流程从“人写代码、人走流程”,升级为“AI 负责闭环执行、人类把控关键治理与评判”的全新协作范式。

    🔗 原文链接:https://claude.com/blog/the-ai-native-sdlc-playbook

    #AI开发 #SDLC #ClaudeCode #软件工程 #人工智能 The AI-Native SDLC playbook | Claude by Anthropic

  4. 从“生成报告”到“解决复杂任务”:Apodex 1.1 正式发布传统的 AI 深度搜索往往以生成一份结构化报告为终点,但科研、金融和法律等领域的真实工作,通常在写完报告后才刚开始——清洗脏数据、选择方法、编写运行代码、根据中间结果调整方案,并保证每项结论都能经得起溯源检验

    从“生成报告”到“解决复杂任务”:Apodex 1.1 正式发布

    传统的 AI 深度搜索往往以生成一份结构化报告为终点,但科研、金融和法律等领域的真实工作,通常在写完报告后才刚开始——清洗脏数据、选择方法、编写运行代码、根据中间结果调整方案,并保证每项结论都能经得起溯源检验。

    针对这一痛点,Apodex 正式推出了 Apodex 1.1,旨在将 AI 从单纯的“问答工具”升级为能够处理长周期、多阶段复杂任务的在线工作台。

    ---

    核心亮点一览

    1. 真实环境下的长链路执行

    不再回避复杂的专业格式(CSV、PDF、分子结构等)。模型在真实的文件与代码环境中运行,自主处理异常并完成端到端的数据分析与交付。

    2. 支持运行中随时介入(Human-in-the-loop)

    复杂任务难免需要中途调整。Apodex 1.1 允许用户在任务执行的任意阶段添加新需求或新数据,系统会自动保留有效的中间产物并重新规划后续路径,无需从头再来。

    3. 任务分解与执行状态全透明

    拒绝黑盒等待。基于底层 AgentOS,系统会实时展示当前的执行计划、完成步骤、生成的产物与异常重试情况,让长耗时任务清晰可控。

    4. 自主异步多智能体团队(Agent Team)

    在 Deep Discover 模式下,模型会自主将复杂任务拆解并分发给多个子智能体并行探索。中间结果实时回流至主任务,大幅缩短复杂探索的等待耗时。

    5. 关键结论独立审查(Statement Review)

    将“内容生成”与“结论审核”解耦。针对数据推论、文献引用和计算结果进行独立的交叉校验与证据链追溯,显著降低幻觉风险。

    6. 开源支持与端侧部署

    除了网页端完整版,团队还推出了可本地部署的 35B Apodex 1.1 Mini,并开源了开箱即用的终端智能体框架 FrontierAgent(支持 macOS / Linux 单命令运行)。

    ---

    🔗 原文链接:https://www.apodex.com/blog/apodex-1.1-scaling-agentic-intelligence-for-complex-work

    #人工智能 #AI智能体 #Apodex #大语言模型 #深度研究 Apodex | Self-Evolving Heavy-Duty Solver

  5. 通俗解读:什么是 AI 时代的「Agent Harness」?业界常用一个极简公式来定义智能体:Agent = Model + Harness

    通俗解读:什么是 AI 时代的「Agent Harness」?

    业界常用一个极简公式来定义智能体:Agent = Model + Harness

    如果把大模型(Model)比作攀登者的核心力量,那么 Harness(原意为登山安全带/挽具) 就是为你提供支撑、挂载工具并确保安全的整套装备。

    在 AI 领域,Agent Harness 是为模型提供运行环境的软件外壳。它主要承担四个核心职能:

    1. 系统提示(System Prompt):像给新员工的工作指引,规范模型在特定场景下的行为准则。
    2. 工具挂载(Tools):为模型提供搜索、写代码、发邮件等能力接口,并由模型自主判断何时调用。
    3. 自主循环(Agentic Loop):构建「理解任务 ➔ 调用工具 ➔ 评估结果 ➔ 自主修正 ➔ 交付成果」的完整工作流闭环。
    4. 模型转换层(Translation Layer):抹平不同大模型(OpenAI、Anthropic、开源模型等)的接口差异,支持灵活切换与混用。

    为什么 Harness 越来越重要?
    大模型往往掌握在少数巨头手中,但 Harness 可以开源并运行在本地。借助像 Pi、OpenClaw 这类中立的开源框架,用户能够将控制权掌握在自己手中,按需定制属于自己的 AI 工作流。

    阅读原文:https://earendil.com/posts/what-is-a-harness/

    #AI智能体 #Agent #人工智能 #开源技术 What is a Harness? | EARENDIL

  6. 超越 Git:Zed 推出专为 AI 协作打造的版本控制系统 DeltaDB代码的诞生正逐渐从“提交(Commit)”转向“对话(Conversation)”

    超越 Git:Zed 推出专为 AI 协作打造的版本控制系统 DeltaDB

    代码的诞生正逐渐从“提交(Commit)”转向“对话(Conversation)”。传统的 Git 机制已无法满足人与人、人与 AI 代理(Agent)之间的高频实时协作。为此,现代编辑器 Zed 宣布推出全新的版本控制系统——DeltaDB

    与通过 Commit 捕获代码快照的 Git 不同,DeltaDB 的核心理念是将开发过程中的每一次微小操作(Delta)都记录下来。它的主要特性包括:

    记录每一次操作:不仅是 Commit,DeltaDB 会捕获每一次编辑并赋予其唯一身份,支持随时回溯任意时刻的代码状态,并允许多人与 AI 共同实时修改同一文件。
    代码与对话无缝绑定:版本控制不再只针对代码,还包括促成这些代码的对话。你可以从任意一行代码追溯到生成它的讨论上下文,AI 也可以借此理解代码的设计初衷。
    消除繁琐的协作仪式:无需等待 Commit、Push 和 Pull Request。团队成员可以随时加入正在进行的工作区,直接与 AI 或同事交流,让沟通在编写代码的瞬间发生。

    DeltaDB 旨在让 Git 和 CI 回归它们最擅长的安全检查与发布功能,而把日常协作留给更实时的工具。该系统预计在几周内开启 Beta 测试。

    原链接:https://zed.dev/blog/introducing-deltadb

    #DeltaDB #Zed #版本控制 #协同开发 #AI时代 Software Is Made Between Commits

  7. 让 AI 自主付费:Cloudflare 推出面向 Agent 的可编程钱包在 AI 时代,智能体(Agent)想要尝试新的 API 或付费内容并不容易

    让 AI 自主付费:Cloudflare 推出面向 Agent 的可编程钱包

    在 AI 时代,智能体(Agent)想要尝试新的 API 或付费内容并不容易。它们既没有稳定的身份去注册,也无法像人类一样直接绑定信用卡,这大大限制了“智能体商业”的发展。

    为了解决这一痛点,Cloudflare 宣布推出 Cloudflare Wallets,为 AI 智能体提供原生的支付与身份验证方案。

    核心设计与功能:

    双层钱包架构
    账户钱包 (Account Wallets):由人类账号所有者管理,负责资金充值与规则制定。
    虚拟钱包 (Virtual Wallets):分配给 AI 智能体使用。人类可以为其设置“零花钱”限额、白名单和单次交易上限,让 AI 在可控风险内自主测试不同的 API 服务。
    微支付支持:结合 Monetization Gateway,钱包利用 x402 协议实现了将支付信息直接附加在 HTTP 请求中,极大地简化了机器对机器的交易流程。
    可读的智能体身份:用户可以为自己的账户申领 cloudflare.pay 域名。AI 智能体在访问服务时,可以通过如 research.example.cloudflare.pay 这样的可读标识公开身份,便于商家提供试用额度或进行白名单管理。

    Cloudflare Wallets 的推出,意味着未来互联网将迎来一个专为 AI 设计的、无缝的“机器原生”交易市场。

    原链接:https://blog.cloudflare.com/wallets/

    #Cloudflare #AI智能体 #数字钱包 #网络支付 #微支付 Announcing Cloudflare Wallets: The programmable wallet for the agentic Internet

  8. 开源 AI 模型安全吗?Cognition 发布可信度评估报告低成本且广泛可用的开源模型正在推动 AI 应用的爆发,但它们的安全性和可信度也引发了广泛担忧

    开源 AI 模型安全吗?Cognition 发布可信度评估报告

    低成本且广泛可用的开源模型正在推动 AI 应用的爆发,但它们的安全性和可信度也引发了广泛担忧。为此,智能体开发商 Cognition 建立了一套模型可信度评估体系,并对其基于开源模型 Kimi K2.7 Code 训练的软件工程模型 SWE-1.7 进行了深度测试。

    测试主要从以下三个维度展开:

    1. 政治宣传与审查过滤

    测试使用包含 145 个敏感问题的测试集,评估模型在不同语言下的中立性。结果显示,一些来自中文社区的开源模型在中文语境下容易输出带有偏向性的特定叙事。而经过优化后的 SWE-1.7,其答复中立性表现已经与 GPT 5.5、Claude Opus 等顶级闭源模型不相上下。

    2. 恶意请求的拒绝能力

    在面对具有潜在危害的开发请求(例如编写用于非法监控特定人群的代码)时,原始开源模型(如 Kimi K2.7)往往会盲目顺从,甚至主动完善监控功能。而 SWE-1.7 则能准确识别风险并坚决予以拒绝。

    3. 针对特定对象的“潜在安全隐患”

    此前有研究称,部分开源模型在面对特定用户身份(如某些政府机构或组织)时,可能会故意降低代码安全性。Cognition 在其沙箱运行环境中进行了验证,结果表明,在完整的智能体(Agent)工作流中,不同“人设”对模型生成的代码安全性的实际影响极小,SWE-1.7 在各种背景下均能保持稳定、一致的代码质量。

    结论
    开源模型本身并不是天然不安全的。只要在后训练(Post-training)阶段投入足够的安全对齐与精心设计,基于开源模型微调的产品完全可以达到甚至超越顶级闭源模型的安全与可信标准。

    https://cognition.com/blog/measuring-open-source-model-trustworthiness

    #人工智能 #开源模型 #AI安全 #大模型 #Cognition Measuring the Trustworthiness of Open-Source-Derived Models

  9. Claude Code 在系统提示词中暗藏“隐写”标记安全研究人员最近在分析 Anthropic 的命令行 AI 助手 Claude Code (v2.1.196) 时,发现其内部包含一段特殊的代码

    Claude Code 在系统提示词中暗藏“隐写”标记

    安全研究人员最近在分析 Anthropic 的命令行 AI 助手 Claude Code (v2.1.196) 时,发现其内部包含一段特殊的代码。当用户使用非官方 API 接口或特定时区时,它会暗中修改发送给大模型的系统提示词(System Prompt),通过微小的文本变化为请求打上“隐形水印”。

    隐写机制是如何工作的?

    这种机制主要通过修改系统提示词中“今天日期”的文本格式来实现,极其隐蔽:

    1. 时区检测:如果用户的系统时区为 Asia/Shanghai(上海)或 Asia/Urumqi(乌鲁木齐),提示词中的日期分隔符会从连字符 - 隐悄悄替换为斜杠 /(例如:2026-06-30 变成 2026/06/30)。
    2. 自定义域名检测:如果用户设置了环境变量 ANTHROPIC_BASE_URL(通常用于使用自定义网关、本地代理或中转 API),Claude Code 会检测该域名,并微调 "Today's" 中单引号 ' 的 Unicode 字符(例如替换为 ʻʼ)。在大多数等宽字体中,这些字符的视觉差异极小,用户几乎无法察觉。

    针对的目标

    代码中包含一个经过混淆处理(Base64 编码并进行 XOR 解密)的关键词和域名列表。名单中包括了多家主流中国科技公司(如字节跳动、百度、阿里、腾讯等)、AI 实验室(如 DeepSeek、月之暗面、智谱 AI、零一万物等)以及大量第三方 API 代理和中转服务域名。

    为什么令人担忧?

    Anthropic 这么做很可能是为了在后端识别非官方的 API 转售商、未授权的网关,或是防止模型被用于“蒸馏”训练。

    虽然防范滥用合情合理,但这种“隐写”的实现方式引发了安全社区的质疑。作为一个拥有本地文件系统读写、执行 Shell 命令、甚至管理 Git 仓库等极高权限的开发者工具,建立信任至关重要。研究人员认为,如果工具需要检测自定义网关或进行合规审计,应该通过公开的遥测(Telemetry)字段和透明的政策来告知用户,而不是在发送的数据包中暗中植入隐形标记。

    对于直接使用 Anthropic 官方 API 且未修改 Base URL 的普通用户,该机制不会被触发。

    https://thereallo.dev/blog/claude-code-prompt-steganography

    #网络安全 #AI安全 #隐私保护 #Claude #逆向工程 Claude Code Is Steganographically Marking Requests

  10. BRAIN.md:为项目构建 AI 友好的决策记忆库在日常开发中,我们常用 README.md 告诉人类如何上手,用 AGENTS.md 指导 AI 怎么在项目中编写代码

    BRAIN.md:为项目构建 AI 友好的决策记忆库

    在日常开发中,我们常用 README.md 告诉人类如何上手,用 AGENTS.md 指导 AI 怎么在项目中编写代码。但项目的核心决策——比如“为什么选择 Postgres 而不是 MongoDB”、“架构设计的底层逻辑是什么”——应该记在哪里?

    BRAIN.md 提出了一个全新的开源标准,旨在项目中建立一个专为 AI 和人类准备的决策记忆库。它不是零散的笔记,而是经过整理、权威的“决策级知识”。

    核心特性

    无外部依赖:无需运行任何后台服务或 MCP 服务器,仅基于纯 Markdown 文件约定和一个零依赖的本地 CLI 工具。
    Git 原生支持:所有知识和决策记录在项目根目录下的 brain/ 文件夹中,随代码一起进行版本控制。
    结构化页面设计:核心页面包含 compiled_truth(当前权威结论)和 timeline(追加式的历史证据链)。AI 在读取时能瞬间掌握当前现状,并在需要时追溯历史决策过程。
    智能体通用:目前已原生支持 Claude Code 和 Codex,通过简单的全局安装,即可让你的 AI 助手在开发时直接读取项目的“大脑”。

    通过 BRAIN.md,AI 编程助手不仅是在盲目地写代码,而是能够真正理解项目背后的架构决策与技术取舍,从而产出更具上下文合理性的代码。

    原链接:https://projectbrain.md/

    #软件工程 #AI工具 #开发规范 #知识库 #项目管理 BRAIN.md — A persistent memory layer for your projects

  11. 让 AI 拥有大厂审美:面向 AI 编程助手的 DESIGN.md 模板库用 Cursor、Claude Code 或 v0 写前端代码时,AI 生成的界面总是缺少质感?这通常是因为 AI 缺乏明确的「设计规范」

    让 AI 拥有大厂审美:面向 AI 编程助手的 DESIGN.md 模板库

    用 Cursor、Claude Code 或 v0 写前端代码时,AI 生成的界面总是缺少质感?这通常是因为 AI 缺乏明确的「设计规范」。

    Refero Styles 收集了超过 2000 个来自 Stripe、Vercel、Apple、Claude、Linear 等顶尖产品的设计系统,并将其整理为 AI 易读的格式。

    核心亮点:

    大厂设计规范一键复制:涵盖知名网站的配色、字体排版、间距和 UI 组件规范。
    专为 AI 优化 (DESIGN.md):格式对 AI 编程助手高度友好,直接导入 Cursor、Claude Code 或 Lovable,即可让 AI 像素级还原你喜欢的设计风格。
    Refero MCP 插件支持:通过 Model Context Protocol (MCP),你可以直接让 AI 助手搜索和学习真实产品的界面与用户流,让 AI 拥有真正的「设计品味」。

    如果你想让 AI 写出的网页告别“塑料感”,不妨去这个网站为你的项目挑一个高质量的设计规范。

    https://styles.refero.design/

    #AI编程 #UI设计 #前端开发 #Cursor #设计系统 DESIGN.md Examples for AI Agents | Refero Styles

  12. AI 编程防翻车:MDN 正式推出 MCP 服务,让 AI 获取最新 Web 规范在大模型辅助编程的时代,你是否也遇到过 AI 给出过时 Web API,或错误浏览器兼容性数据的情况?为了解决这一痛点,MDN 官方宣布推出了 MDN MCP(Model Context Protocol)服务

    AI 编程防翻车:MDN 正式推出 MCP 服务,让 AI 获取最新 Web 规范

    在大模型辅助编程的时代,你是否也遇到过 AI 给出过时 Web API,或错误浏览器兼容性数据的情况?

    为了解决这一痛点,MDN 官方宣布推出了 MDN MCP(Model Context Protocol)服务

    什么是 MDN MCP?

    MCP 是一种开放标准,允许 AI 工具安全地连接到外部数据源。通过 MDN MCP,你可以将最新的 MDN 官方文档和浏览器兼容性数据(BCD)直接接入到你常用的 AI 编辑器(如 Cursor、VS Code、Zed)或命令行工具(如 Claude Code)中。

    它能带来什么改变?

    消除 AI 幻觉与信息滞后:避免 AI 因“知识库截止时间”而给出过时信息。例如,它能准确告知你 Firefox 151 已支持 Web Serial API,而未启用 MCP 的 AI 则会根据旧数据坚称“Firefox 不支持”。
    响应速度翻倍:测试表明,启用 MCP 后,AI 响应速度提升了约一倍。AI 无需再耗时爬取和解析网页,而是直接通过协议获取结构化数据。
    快速配置:以 Claude Code 为例,只需运行一行命令即可快速集成:
    claude mcp add --transport http mdn https://mcp.mdn.mozilla.net/

    目前该服务已处于实验阶段,感兴趣的开发者不妨立即配置,让你的 AI 助手掌握最权威的 Web 开发知识库。

    原链接:https://developer.mozilla.org/en-US/blog/introducing-mdn-mcp-server/

    #AI编程 #MDN #MCP #前端开发 #大语言模型

  13. omp:直接集成 IDE 能力的终端 AI 编码助手oh my pi (omp) 是一个专为终端设计的开源 AI 编码智能体

    omp:直接集成 IDE 能力的终端 AI 编码助手

    oh my pi (omp) 是一个专为终端设计的开源 AI 编码智能体。它不仅是一个代码生成器,更是一个深度集成 IDE 工具的“全能型选手”,旨在为开发者提供开箱即用、无缝连接的终端开发体验。

    核心亮点:

    深度集成 IDE 工具链:内置 LSP(Language Server Protocol),AI 能够像在 IDE 中一样精准进行跨文件重命名与格式化;同时支持 DAP(Debug Adapter Protocol),可以直接启动调试器(如 lldb, dlv, debugpy)进行单步调试和堆栈排查。
    创新的 Snapcompact 图像压缩:当对话历史过长时,omp 不使用 LLM 进行文本总结,而是将历史记录渲染成极其微小的像素字体 PNG 图像,并发送给多模态模型读取。这一技术能够确保上下文细节不丢失,且仅消耗约 1/3 的 Token 成本。
    强悍的 Rust 原生引擎:核心由约 5.5 万行 Rust 代码构建,搜索、shell、AST 分析等高频操作均在进程内完成,避免频繁 fork 子进程,效率极高。
    本地化记忆与离线整理:使用本地 SQLite 矢量记忆库,并使用本地的小模型(如 Qwen-1.7B / Gemma-1B)在本地整理记忆与会话标题,数据不离设备。
    强大的协作与扩展性:支持通过 /collab 实现端到端加密的实时会话共享;兼容多种主流编辑器规则(如 Cursor, Cline, Copilot),甚至可以通过 ACP 协议直接在 Zed 编辑器中驱动终端中的同一个 omp 实例。

    原链接:https://omp.sh/

    #AI编码助手 #编程工具 #Rust #开源项目 #智能开发 omp — a coding agent with the IDE wired in

  14. 慢即是快:如何利用 AI 写出更高质量的代码很多人认为,AI 编程的意义在于“快”——以最快的速度堆砌出勉强能运行的代码,然后匆忙合并发布

    慢即是快:如何利用 AI 写出更高质量的代码

    很多人认为,AI 编程的意义在于“快”——以最快的速度堆砌出勉强能运行的代码,然后匆忙合并发布。但这种“快”往往伴随着低质量和技术债。

    实际上,大语言模型(LLM)非常灵活,我们完全可以反其道而行之:利用 AI,用更慢的速度写出质量更高的代码。

    以下是这种“慢速 AI 编程”的核心思路:

    让 AI 成为挑剔的 Review 助手:LLM 极其擅长寻找 Bug。你可以通过设置特定的“技能(Skills)”,让多个不同的模型(如 Claude 和 GPT)同时对你的 PR 进行审查并给 Bug 分级,通过交叉验证有效降低误报率。
    主导修复与取舍:根据 AI 反馈的 Bug 列表,优先引导 AI 修复高危和中度漏洞。如果发现架构设计有根本性问题,甚至可以果断放弃现有的 PR 重新构思。
    把“修 Bug”当成探索之旅:这种工作流虽然不会提升你的“开发速度”,但常常会帮你揪出代码库中早已存在的历史遗留 Bug。在解决这些问题的过程中,你会编写更多单测,深入理解系统的边缘情况。

    这并不是那种吹嘘“10倍效率”的浮躁开发方式,而是一种更健康的编程状态:借力 AI,更严谨、更方法论地对待每一行代码,让代码库保持健康。

    下次使用 AI 时,不妨慢下来,试着问问它:“我的这段代码可能会在哪里崩溃?”

    https://nolanlawson.com/2026/05/25/using-ai-to-write-better-code-more-slowly/

    #AI编程 #代码质量 #软件工程 #程序员

  15. 让 AI 掌握顶级设计:TypeUI 风格库还在烦恼 AI 生成的网页风格太普通?TypeUI 为 Claude、Cursor、Gemini 等 AI 工具提供了一套精选的“设计技能(Design Skills)”库,让你的 AI 助手瞬间化身顶级设计师

    让 AI 掌握顶级设计:TypeUI 风格库

    还在烦恼 AI 生成的网页风格太普通?TypeUI 为 Claude、Cursor、Gemini 等 AI 工具提供了一套精选的“设计技能(Design Skills)”库,让你的 AI 助手瞬间化身顶级设计师。

    核心功能:

    多样化风格: 涵盖 Bento(盒式)、Neumorphism(新态设计)、Glassmorphism(毛玻璃)、Neobrutalism(新野兽派)等多种流行审美。
    即插即用: 提供优化的 skill.md 文件,你可以通过 CLI 命令(如 npx typeui.sh pull bento)直接引入项目,或手动复制到提示词中。
    完美适配: 专门针对 Agentic AI 工具进行了优化,确保 AI 生成的代码能精准还原特定的视觉风格。

    使用场景:
    当你使用 AI 开发网页或应用时,只需喂入这些预设的“技能文件”,AI 就能跳出默认的 Bootstrap 或 Tailwind 风格,构建出极具辨识度的视觉界面。

    原文链接:https://www.typeui.sh/design-skills

    #AI设计 #前端开发 #TypeUI #UI设计 #AI工具

  16. Paseo:随时随地指挥你的 AI 编程助手想要在离开工位时也能继续推进代码进度?Paseo 是一款开源、自托管的 AI 编程 Agent 调度平台,让你能够从手机、桌面或终端轻松管理和运行 AI 助手

    Paseo:随时随地指挥你的 AI 编程助手

    想要在离开工位时也能继续推进代码进度?Paseo 是一款开源、自托管的 AI 编程 Agent 调度平台,让你能够从手机、桌面或终端轻松管理和运行 AI 助手。

    主要功能亮点:

    全平台覆盖:支持 iOS、Android、桌面端及 Web,甚至可以直接通过 CLI 脚本化运行,实现多端无缝衔接。
    集成主流 Agent:完美支持 Claude Code、Codex 和 OpenCode 等主流 AI 编程助手,保留原有的技能和配置。
    隐私与安全:代码始终保留在你的本地机器上,支持端到端加密中继,确保远程连接时的代码安全。
    本地语音交互:内置完全本地化的语音识别与合成技术,无需将语音数据上传云端即可实现指令下达。
    开发者友好:支持键盘快捷键优先操作、Git 工作流隔离(Worktrees)以及全方位的命令行支持。

    Paseo 是一款纯粹的开源工具,不直接调用推理 API,而是作为官方 CLI 的透明调度层,既自由又强大。

    https://paseo.sh/

    #AI编程 #开源项目 #Paseo #开发者工具 #人工智能 Paseo – Run Claude Code, Codex, Copilot, OpenCode from anywhere

  17. AI 时代怎么招工程师:Augment 的「AI-native」人才标准当 AI agent 能写出大部分代码后,工程师的价值开始上移:不再以“写得快、写得多”为核心,而是以判断力、系统设计与协同能力决定产出质量

    AI 时代怎么招工程师:Augment 的「AI-native」人才标准

    当 AI agent 能写出大部分代码后,工程师的价值开始上移:不再以“写得快、写得多”为核心,而是以判断力、系统设计与协同能力决定产出质量。

    Augment 重新梳理了面向 AI-native(与 AI 共同工作)团队的招聘标准,核心变化可以概括为一句话:人从“作者”变成“架构师与编辑”——定义意图、做取舍、设护栏、把好质量关。

    工程师工作重心的迁移

    • 传统工程:写代码、实现方案、解决问题、看个人产出
    • AI-native 工程:明确意图与权衡、编排 agent、选择正确问题、看系统级结果

    他们认为最重要的 6 个能力维度

    1. 产品与结果品味(Product & Outcome Taste):能否在代码变“更便宜”时,避免做出“最贵的错误”——把方向做错。
    2. 系统与架构判断(System & Architectural Judgment):代码能跑不难,难的是“能在生产环境长期稳定地跑”。
    3. Agent 杠杆(Agent Leverage):能否把 AI 变成真实吞吐量:拆解任务、引导偏航、验证结果(agent 很快,但也可能自信地出错)。
    4. 沟通与协作(Communication & Collaboration):实现更快后,“达成清晰”更关键;要能把意图讲清楚、促成共识。
    5. 主人翁意识与领导力(Ownership & Leadership):对结果负责而非只做任务;主动清除阻碍交付的障碍。
    6. 学习速度与实验心态(Learning Velocity & Experimental Mindset):工具三个月就变一轮,持续实验与快速迭代成为工作常态。

    一个显著的信号是:“纯粹的编码能力”不再是最主要的区分项——依然重要,但不再决定上限。

    从理念到招聘:看“可观察信号”

    他们强调,框架必须能落到面试里,转成可评估的行为证据,例如:

    • 能否快速澄清模糊问题、定义清晰目标?
    • 能否提前识别架构风险,而不是上线后救火?
    • 能否有效指挥并验证 AI 生成的工作?

    未来重点招的 4 类画像

    AI-native 系统工程师:基础设施与架构判断强,保证“地基”稳。
    AI-native 产品工程师:产品品味与用户理解强,确保“做对事”。
    AI-native 应用 AI 工程师:懂模型与应用构建,提升 agent 能力与工作流。
    AI-native 早期工程师(Early Professional):学习速度优先,快速适应工具与流程变化。

    这套标准也不只用于招聘,还会反向影响绩效、成长与职业发展:如果真正重视判断力、杠杆与学习速度,就应该在各个环节都体现出来。

    原文链接:https://www.augmentcode.com/blog/how-we-hire-ai-native-engineers-now

    #AI招聘 #工程师能力 #AI代理 #架构设计 #学习型组织 How we hire AI-native engineers now: our criteria

  18. GitHub Agentic Workflows:用自然语言写 GitHub Actions 的“智能工作流”GitHub 开源项目 gh-aw(GitHub Agentic Workflows),主打一个思路:用自然语言 Markdown 编写“代理式(agentic)工作流”,然后直接在 GitHub Actions 里运行,让 AI 代你完成仓库中的重复性任务

    GitHub Agentic Workflows:用自然语言写 GitHub Actions 的“智能工作流”

    GitHub 开源项目 gh-aw(GitHub Agentic Workflows),主打一个思路:用自然语言 Markdown 编写“代理式(agentic)工作流”,然后直接在 GitHub Actions 里运行,让 AI 代你完成仓库中的重复性任务。

    它提供的核心价值包括:

    更低门槛的工作流编写方式:用 Markdown 描述要做什么,而不是从零写复杂的 YAML/脚本
    更强调安全的执行模型(Guardrails):默认只读权限;写入操作需要通过经过清洗的 safe-outputs;并配套多层防护(输入净化、工具白名单、编译期校验、网络隔离、供应链安全等)
    完善的文档与上手路径:官方提供 Quick Start 与完整文档,方便快速跑通示例并理解整体机制
    生态配套
    AWF(Agent Workflow Firewall):限制与记录代理的网络访问(出站控制)
    MCP Gateway:统一转发 MCP(Model Context Protocol)服务调用,便于集中管理访问

    适合关注 AI + DevOps、希望把“AI 介入仓库日常操作”做得更可控、更工程化的团队参考与尝试(同时也要保持必要的人类监督)。

    原链接:https://github.com/github/gh-aw

    #GitHubActions #AI自动化 #工作流 #安全工程 #开源项目 GitHub - github/gh-aw: GitHub Agentic Workflows

  19. Entire:把 AI 编程对话“写进”每一次 Git 提交用 AI 写代码时,最容易丢的不是代码,而是“为什么这么写”的上下文

    Entire:把 AI 编程对话“写进”每一次 Git 提交

    用 AI 写代码时,最容易丢的不是代码,而是“为什么这么写”的上下文。Entire 提供一个思路:在你正常的 git 工作流里,把每次 AI agent 会话自动记录下来,并与对应的 commit 绑定,形成可搜索的历史记录。

    它能做什么?

    自动捕获会话:在每次 push 时记录 AI agent 的会话内容,并和提交一起关联。
    不改变你的工作方式:通过 CLI 接入现有工具链,尽量减少上下文切换。
    支持多种 agent:目前支持 Claude CodeGoogle Gemini;OpenAI Codex 等集成在路上。
    把“意图”留在仓库里:官方强调记录会直接存进 git 历史,不依赖额外托管服务或外部数据库。

    安装方式(官网给出的命令)

    curl -fsSL https://entire.io/install.sh | bash

    适合希望团队更容易复盘决策、追踪 AI 产出过程、减少重复踩坑的工程项目。

    原链接:http://entire.io/

    #Git #AI编程 #开发工具 #工程效率 #CLI Entire · A new developer platform is coming

  20. Stripe「Minions」:一键生成、端到端交付的无人值守编码代理Stripe 在内部打造了一套名为 Minions 的编码代理:从接到任务到产出可评审的 PR,全程几乎无需人类介入

    Stripe「Minions」:一键生成、端到端交付的无人值守编码代理

    Stripe 在内部打造了一套名为 Minions 的编码代理:从接到任务到产出可评审的 PR,全程几乎无需人类介入。现在,Stripe 每周有超过 1000 个合并的 PR 是由 Minions 从头到尾生成的(人类负责 Review,但不写代码)。

    为什么要自研?

    在 Stripe 这种超大规模、强约束的工程环境里,“从零写个原型”和“在成熟巨型代码库里安全改动”完全不是一回事:

    • 代码库规模巨大(数亿行),栈也相对小众:大量后端是 Ruby + Sorbet,还有大量 Stripe 自研库,LLM 天然不熟
    • 业务风险极高:Stripe 的代码承载着 每年超过 1 万亿美元 的支付规模,并受金融合规与监管约束
    • 既要让代理“会写”,也要让它“按规矩写、能跑通、能过 CI”,并与既有研发流程深度结合

    工程师怎么用?

    最常见的入口是 Slack

    • 在讨论线程里 @Slack App 就能发起 Minion,它会读取整个线程与相关链接作为上下文
    • 也集成到内部系统里:文档平台、Feature Flag、工单系统等
    例如 CI 发现 flaky tests,会生成工单,直接提供按钮让 Minion 去修

    完成后,Minion 会:

    • 创建分支 → 推送 → 跑 CI → 按模板生成 PR

    如果效果不理想,人类可以补充指令让它再改;即使不完美,也常常是很好的“可用起点”。

    Minions 背后怎么运作(要点版)

    Stripe 的思路是:把“创意生成”交给 LLM,把“必须可靠执行的步骤”交给确定性工具链

    • 运行环境:在隔离的 devbox 中执行(10 秒内可启动,预热并预载代码与服务),与生产与公网隔离,便于并行
    • Agent 框架:基于 Block 的开源编码代理 goose 的 fork,并做了强定制
    • 规则与上下文:读取各类 agent rule 文件,但多为“按目录条件生效”,避免全局死规则拖累
    • 工具调用:接入 MCP(函数调用通用协议),并建设内部 MCP 服务 Toolshed,提供 400+ 工具(文档、工单、构建状态、Sourcegraph 搜索等)
    • 反馈与质量闸门:
    • 首先跑本地启发式 lint/检查(通常 <5 秒)
    • 再跑选择性的 CI(Stripe 有 300 万+ 测试),部分失败可自动修复
    • 为控制成本与等待时间:最多两轮 CI,强调“能本地提前发现就不要拖到 CI”

    接下来

    这篇是系列 Part 1,主要讲“怎么用、能做什么”;Part 2 会深入实现细节。整体信号很明确:当“开发者注意力”成为稀缺资源时,无人值守、可并行的编码代理正在改变工程协作方式。

    原文链接:https://stripe.dev/blog/minions-stripes-one-shot-end-to-end-coding-agents

    #AI工程化 #编码代理 #开发者效率 #CI实践 #Stripe Minions: Stripe’s one-shot, end-to-end coding agents

1px