算力战国策:拆解主流 AI 芯片的技术哲学与架构之争
在摩尔定律与登纳德缩放定律放缓后,AI 算力迎来爆发。大模型计算本质上是海量的矩阵乘法(GEMM / GEMV),而决定性能天花板的从来不是单纯的峰值算力,而是数据移动速度——即如何攻破“内存墙”(Memory Wall)。
各大芯片巨头对此给出了截然不同的答卷,形成了当下六大主流 AI 芯片路线:
---
1. NVIDIA GPU:极致通用与生态壁垒
• 核心哲学:高度并行的通用处理器。通过 CUDA 保留统一的编程模型,将硬件复杂度包装在 SM 与 Tensor Core 背后。
• 架构亮点:通过硬件管理缓存与海量线程(Warp)隐藏访存延迟;从 Blackwell 到 Rubin,引入 TMEM、异步 TMA 与微缩精度(FP4/NVFP4)。
• 扩展体系:NVLink + NVSwitch 构建低延迟共享内存域;机架级(如 NVL72 / NVL576)坚持采用无源铜缆背板,以极低功耗实现高达 130 TB/s 的全对全互联。
• 护城河:二十年积累的 CUDA 开发者生态与深度优化的算子库(FlashAttention、CUTLASS 等)。
2. Google TPU:脉动阵列与编译器至上
• 核心哲学:专为矩阵乘法而生的专用机器。剔除硬件调度器、分支预测和缓存,把每一拍的调度完全交给 XLA 编译器。
• 架构亮点:权重常驻(Weight-Stationary)的 MXU 脉动阵列,搭配纯软件管理的暂存内存(VMEM/CMEM);引入 SparseCore 处理非规则的 Embedding 与推荐负载。
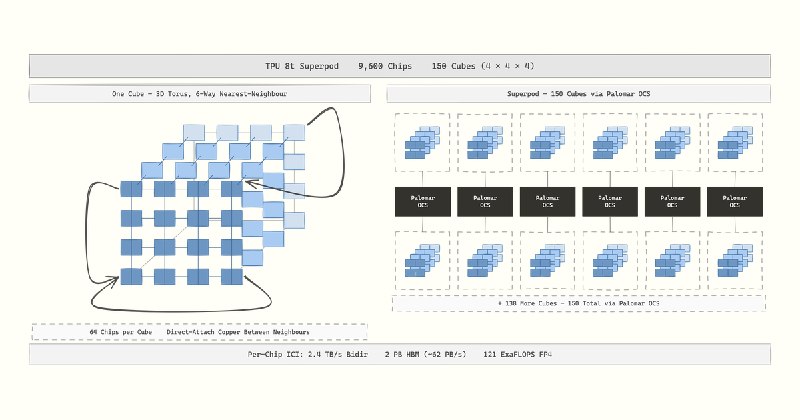
• 扩展体系:以 3D-Torus(环面拓扑)为核心,配合独创的 Palomar OCS(3D-MEMS 光电路交换机),实现无需停机的动态拓扑重构与近万卡级(Ironwood / TPU v8)超大规模 Scale-up Pod。
3. AMD Instinct:先进封装与开源联盟
• 核心哲学:CU 核心架构保持稳健,把算力红利押注在 3D 堆叠封装(TSMC SoIC)与更大容量的 HBM 上。
• 架构亮点:首创 3D 堆叠 GPU 与 CPU+GPU 统一内存架构(MI300A);配备 256MB 超大 Infinity Cache 缓解访存压力。
• 扩展体系:推进开放互联标准 UALink 与以太网 RDMA 标准(UEC/UET),在 Helios 机架上正面迎击 NVL72。
• 软件生态:以 ROCm、HIP、Triton 和 vLLM 为抓手,依托开源社区追赶 CUDA 性能。
4. Cerebras WSE:不切晶圆的极速怪兽
• 核心哲学:内存墙源于把晶圆切成小芯片。Cerebras 直接把整块 300mm 晶圆做成单颗芯片(46,225 mm²)。
• 架构亮点:片上拥有 90 万个数据流核心和 44GB 超高速 SRAM,内部聚合带宽高达 21 PB/s,无 HBM 瓶颈。
• 应用场景:极限追求单 Token 的生成延迟(Decode 速度远超 GPU 数倍),但受限于 SRAM 成本与容量,更适合作为极致低延迟的专用推理节点。
5. AWS Trainium:云端全栈性价比
• 核心哲学:芯片是云服务的组件,只需在 AWS 内部体系内战胜采购 NVIDIA 的成本。
• 架构亮点:借鉴 TPU 的脉动阵列与 OpenXLA 体系,同时在硬件层面原生集成 CC-Core(集合通信核心),让通信与计算在硅片上真正完全并发。
• 扩展体系:自研 NeuronSwitch 扁平互联 + Nitro EFA/SRD 弹性以太网,支撑了 Anthropic 百万卡级别的超大规模集群。
6. Groq LPU:消除一切不确定性的纯静态架构
• 核心哲学:移除所有硬件仲裁器、缓存与动态调度,打造完全确定性(Deterministic)的处理器,执行时间在编译期精确到周期。
• 架构亮点:片上全 SRAM 空间流式处理,数据如流水线般穿过功能切片;多卡之间无需交换机,纯静态编译路由。
• 最终归宿:单卡容量极小、扩展成本高,其低延迟推理技术最终被英伟达吸收,作为超低延迟推理协处理器协同工作。
---
💡 核心趋势与行业共识
1. 单芯片算力趋同,系统工程定胜负:各家旗舰的单芯片 FP8/FP4 峰值已十分接近,竞争焦点彻底转向机架级互联(Scale-up 域大小)、光电混合交换与液冷系统工程。
2. 两极化的内存博弈:一条路是以 HBM 为代表的大容量路线(满足长上下文与大批次吞吐);另一条路是以纯 SRAM 为代表的高带宽路线(追求单用户极致低延迟)。
3. 软件范式收敛:从早期的手写专用底层算子,正逐步向 Triton、MLIR、XLA 等现代编译中间层收敛,软硬件解耦正在打破单一供应商的生态锁定。
🔗 原文链接:https://www.jacobpeake.com/ai-chip-architectures
#AI芯片 #半导体架构 #NVIDIA #TPU #大模型算力
在摩尔定律与登纳德缩放定律放缓后,AI 算力迎来爆发。大模型计算本质上是海量的矩阵乘法(GEMM / GEMV),而决定性能天花板的从来不是单纯的峰值算力,而是数据移动速度——即如何攻破“内存墙”(Memory Wall)。
各大芯片巨头对此给出了截然不同的答卷,形成了当下六大主流 AI 芯片路线:
---
1. NVIDIA GPU:极致通用与生态壁垒
• 核心哲学:高度并行的通用处理器。通过 CUDA 保留统一的编程模型,将硬件复杂度包装在 SM 与 Tensor Core 背后。
• 架构亮点:通过硬件管理缓存与海量线程(Warp)隐藏访存延迟;从 Blackwell 到 Rubin,引入 TMEM、异步 TMA 与微缩精度(FP4/NVFP4)。
• 扩展体系:NVLink + NVSwitch 构建低延迟共享内存域;机架级(如 NVL72 / NVL576)坚持采用无源铜缆背板,以极低功耗实现高达 130 TB/s 的全对全互联。
• 护城河:二十年积累的 CUDA 开发者生态与深度优化的算子库(FlashAttention、CUTLASS 等)。
2. Google TPU:脉动阵列与编译器至上
• 核心哲学:专为矩阵乘法而生的专用机器。剔除硬件调度器、分支预测和缓存,把每一拍的调度完全交给 XLA 编译器。
• 架构亮点:权重常驻(Weight-Stationary)的 MXU 脉动阵列,搭配纯软件管理的暂存内存(VMEM/CMEM);引入 SparseCore 处理非规则的 Embedding 与推荐负载。
• 扩展体系:以 3D-Torus(环面拓扑)为核心,配合独创的 Palomar OCS(3D-MEMS 光电路交换机),实现无需停机的动态拓扑重构与近万卡级(Ironwood / TPU v8)超大规模 Scale-up Pod。
3. AMD Instinct:先进封装与开源联盟
• 核心哲学:CU 核心架构保持稳健,把算力红利押注在 3D 堆叠封装(TSMC SoIC)与更大容量的 HBM 上。
• 架构亮点:首创 3D 堆叠 GPU 与 CPU+GPU 统一内存架构(MI300A);配备 256MB 超大 Infinity Cache 缓解访存压力。
• 扩展体系:推进开放互联标准 UALink 与以太网 RDMA 标准(UEC/UET),在 Helios 机架上正面迎击 NVL72。
• 软件生态:以 ROCm、HIP、Triton 和 vLLM 为抓手,依托开源社区追赶 CUDA 性能。
4. Cerebras WSE:不切晶圆的极速怪兽
• 核心哲学:内存墙源于把晶圆切成小芯片。Cerebras 直接把整块 300mm 晶圆做成单颗芯片(46,225 mm²)。
• 架构亮点:片上拥有 90 万个数据流核心和 44GB 超高速 SRAM,内部聚合带宽高达 21 PB/s,无 HBM 瓶颈。
• 应用场景:极限追求单 Token 的生成延迟(Decode 速度远超 GPU 数倍),但受限于 SRAM 成本与容量,更适合作为极致低延迟的专用推理节点。
5. AWS Trainium:云端全栈性价比
• 核心哲学:芯片是云服务的组件,只需在 AWS 内部体系内战胜采购 NVIDIA 的成本。
• 架构亮点:借鉴 TPU 的脉动阵列与 OpenXLA 体系,同时在硬件层面原生集成 CC-Core(集合通信核心),让通信与计算在硅片上真正完全并发。
• 扩展体系:自研 NeuronSwitch 扁平互联 + Nitro EFA/SRD 弹性以太网,支撑了 Anthropic 百万卡级别的超大规模集群。
6. Groq LPU:消除一切不确定性的纯静态架构
• 核心哲学:移除所有硬件仲裁器、缓存与动态调度,打造完全确定性(Deterministic)的处理器,执行时间在编译期精确到周期。
• 架构亮点:片上全 SRAM 空间流式处理,数据如流水线般穿过功能切片;多卡之间无需交换机,纯静态编译路由。
• 最终归宿:单卡容量极小、扩展成本高,其低延迟推理技术最终被英伟达吸收,作为超低延迟推理协处理器协同工作。
---
💡 核心趋势与行业共识
1. 单芯片算力趋同,系统工程定胜负:各家旗舰的单芯片 FP8/FP4 峰值已十分接近,竞争焦点彻底转向机架级互联(Scale-up 域大小)、光电混合交换与液冷系统工程。
2. 两极化的内存博弈:一条路是以 HBM 为代表的大容量路线(满足长上下文与大批次吞吐);另一条路是以纯 SRAM 为代表的高带宽路线(追求单用户极致低延迟)。
3. 软件范式收敛:从早期的手写专用底层算子,正逐步向 Triton、MLIR、XLA 等现代编译中间层收敛,软硬件解耦正在打破单一供应商的生态锁定。
🔗 原文链接:https://www.jacobpeake.com/ai-chip-architectures
#AI芯片 #半导体架构 #NVIDIA #TPU #大模型算力